AI Agent 应该有记忆,这几乎是大家的共识。
尤其是同时用几个 coding agent 的时候,反复交代背景是一件很消耗人的事。项目做了几周,换一个会话、换一个模型,它至少应该知道我们决定过什么、踩过什么坑,以及哪些事情不要再来一遍。
但装上记忆系统之后,我越来越想知道另一件事:它到底帮了多少忙?
工具调用看起来很活跃,召回的内容也经常和当前任务相关。可这些旧信息,有没有真正进入后面的回复和行动?有没有让 Agent 少犯一个错、少绕一段路,或者做出一个原本不会做出的正确决定?
于是,我把几台机器上的 Agent 会话记录都整理了出来,一共 3,230 份。但先说清楚:3200 是我能收集到的所有的全量 session,真正接入了记忆系统后的有效会话只有 1,078 个,哈哈允许我标题党一下。
我本人是从 6 月 29 日开始高强度使用 Nowledge Mem 的(Opus 5 是 7 月才发布的,好快啊),之前有装但一直没大规模使用,即使时间没这么长,我认为也可以分析出一些东西来了。所以有效会话指的是这天之后,我在 Codex、OpenCode、Kimi Code、Hermes 和 Claude Code 里输入过提示的会话。其余两千多份,有的在开始用记忆之前,有的来自没在用记忆的其他工具和配置,还有子 Agent 记录、自动任务、空记录和读不出来的旧日志。
然后同步一个一个概念,Agent 两次召回记忆之间的 message,我叫它一个召回窗口,我们只统计记忆窗口内 AI 是否真正用到了记忆,这样的分析有有缺陷但看完整个 session 代价过大。不过我们还是拿召回窗口继续来说事,在 1078 个 session 中,我们切割出了 1050 个召回窗口,我让 Claude Opus 5.5 把全部 1,050 个召回窗口逐个复核了一遍,又用同一批真实查询,实测了几种记忆工具的差别。
所以下面是一些核心发现。说实话,第一眼看到的数据,没有我想象中那么惊艳。如果再 case by case 得再去看那些“真正用上记忆”的案例,事情又似乎复杂起来。
核心发现
总览
记忆的典型上下文占用,比我想象中的稍多
在能配对输入 token 记录的 683 次回复、210 个会话里,记忆相关内容占上下文的中位数为 4.1%,P95 为 16.9%。约一半回复的占比不超过 4.1%,约 5% 的回复超过 16.9%。典型情况下,它没有把上下文挤满,但部分回复的占用明显更高。
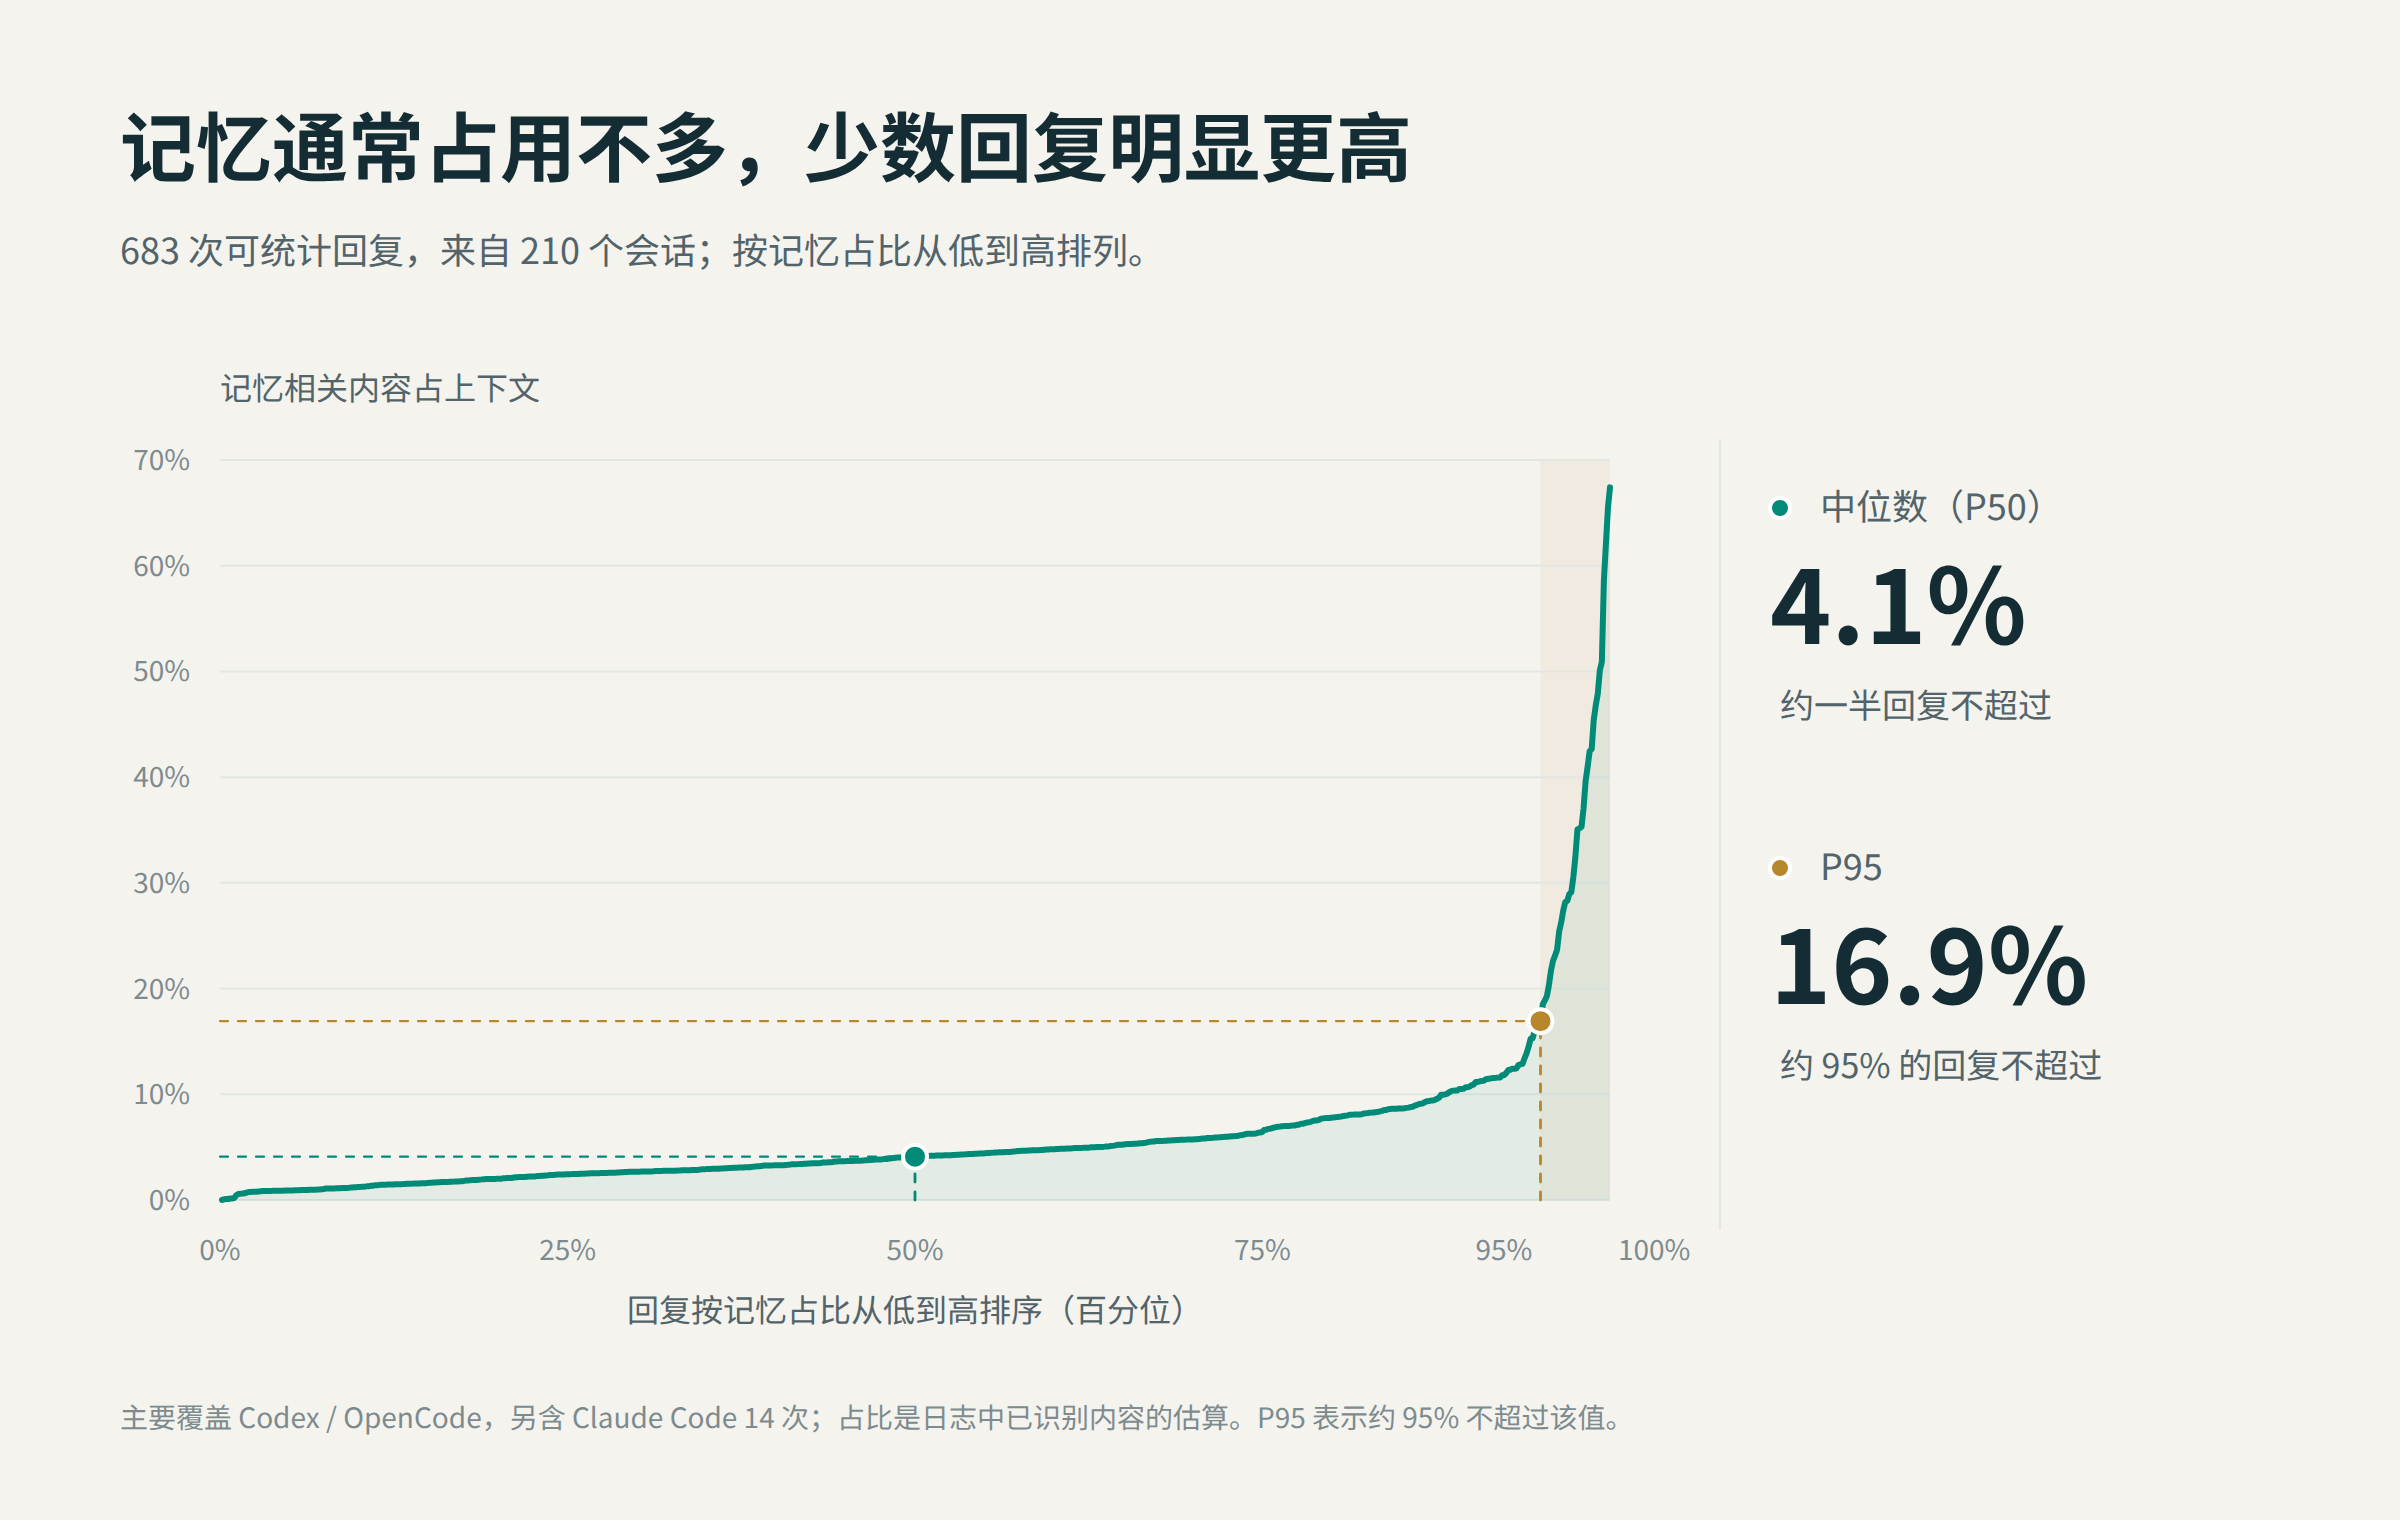
这里包含可见记忆注入、召回返回、工具说明和包装等附带内容。只看已识别的知识正文,占比中位数为 1.8%。这一项主要覆盖 Codex 和 OpenCode(Claude Code 只有 14 次),只统计日志中能够识别的部分;中位数也不等于算术平均值。
能确认被用上的召回不多,进一步推动行动的更少
全部 1,050 个召回窗口中,101 个能看到具体内容被采用。没有足够证据的窗口要不要计入分母,会影响采用率,所以我把同一批数据按两种口径算了一遍:
- 宽泛口径:12.4%(101 / 814)。沿用原来的统计,排除 236 个证据不足的窗口,只在 814 个可判断窗口里计算。
- 严格口径:9.6%(101 / 1,050)。全部召回都计入分母;只要在观察窗口内没有确认采用,就记为一次“失效”。这样,确认采用仍是 101 个,其余 949 个都计为失效,包括前面排除的 236 个。
两种口径的差别只在于是否纳入这 236 个窗口,不改变已有的采用判断。它们也不全是“在窗口外才用到”:其中 89 个返回无法解析,146 个复核后仍无法判断,1 个在回复前日志就结束了。严格口径不追认可能发生在窗口外的使用,但这里的“失效”也不等同于整个任务失败。
101 个采用窗口里,71 个补充了前文没有的信息;既补充新信息、又推动下一步的只有 57 个,按宽泛口径是 7.0%,按严格口径是 5.4%。还有 28 个采用主要是复述或保持一致。这些数字描述的是窗口内观察到的作用,还不能直接等同于任务改善了多少。
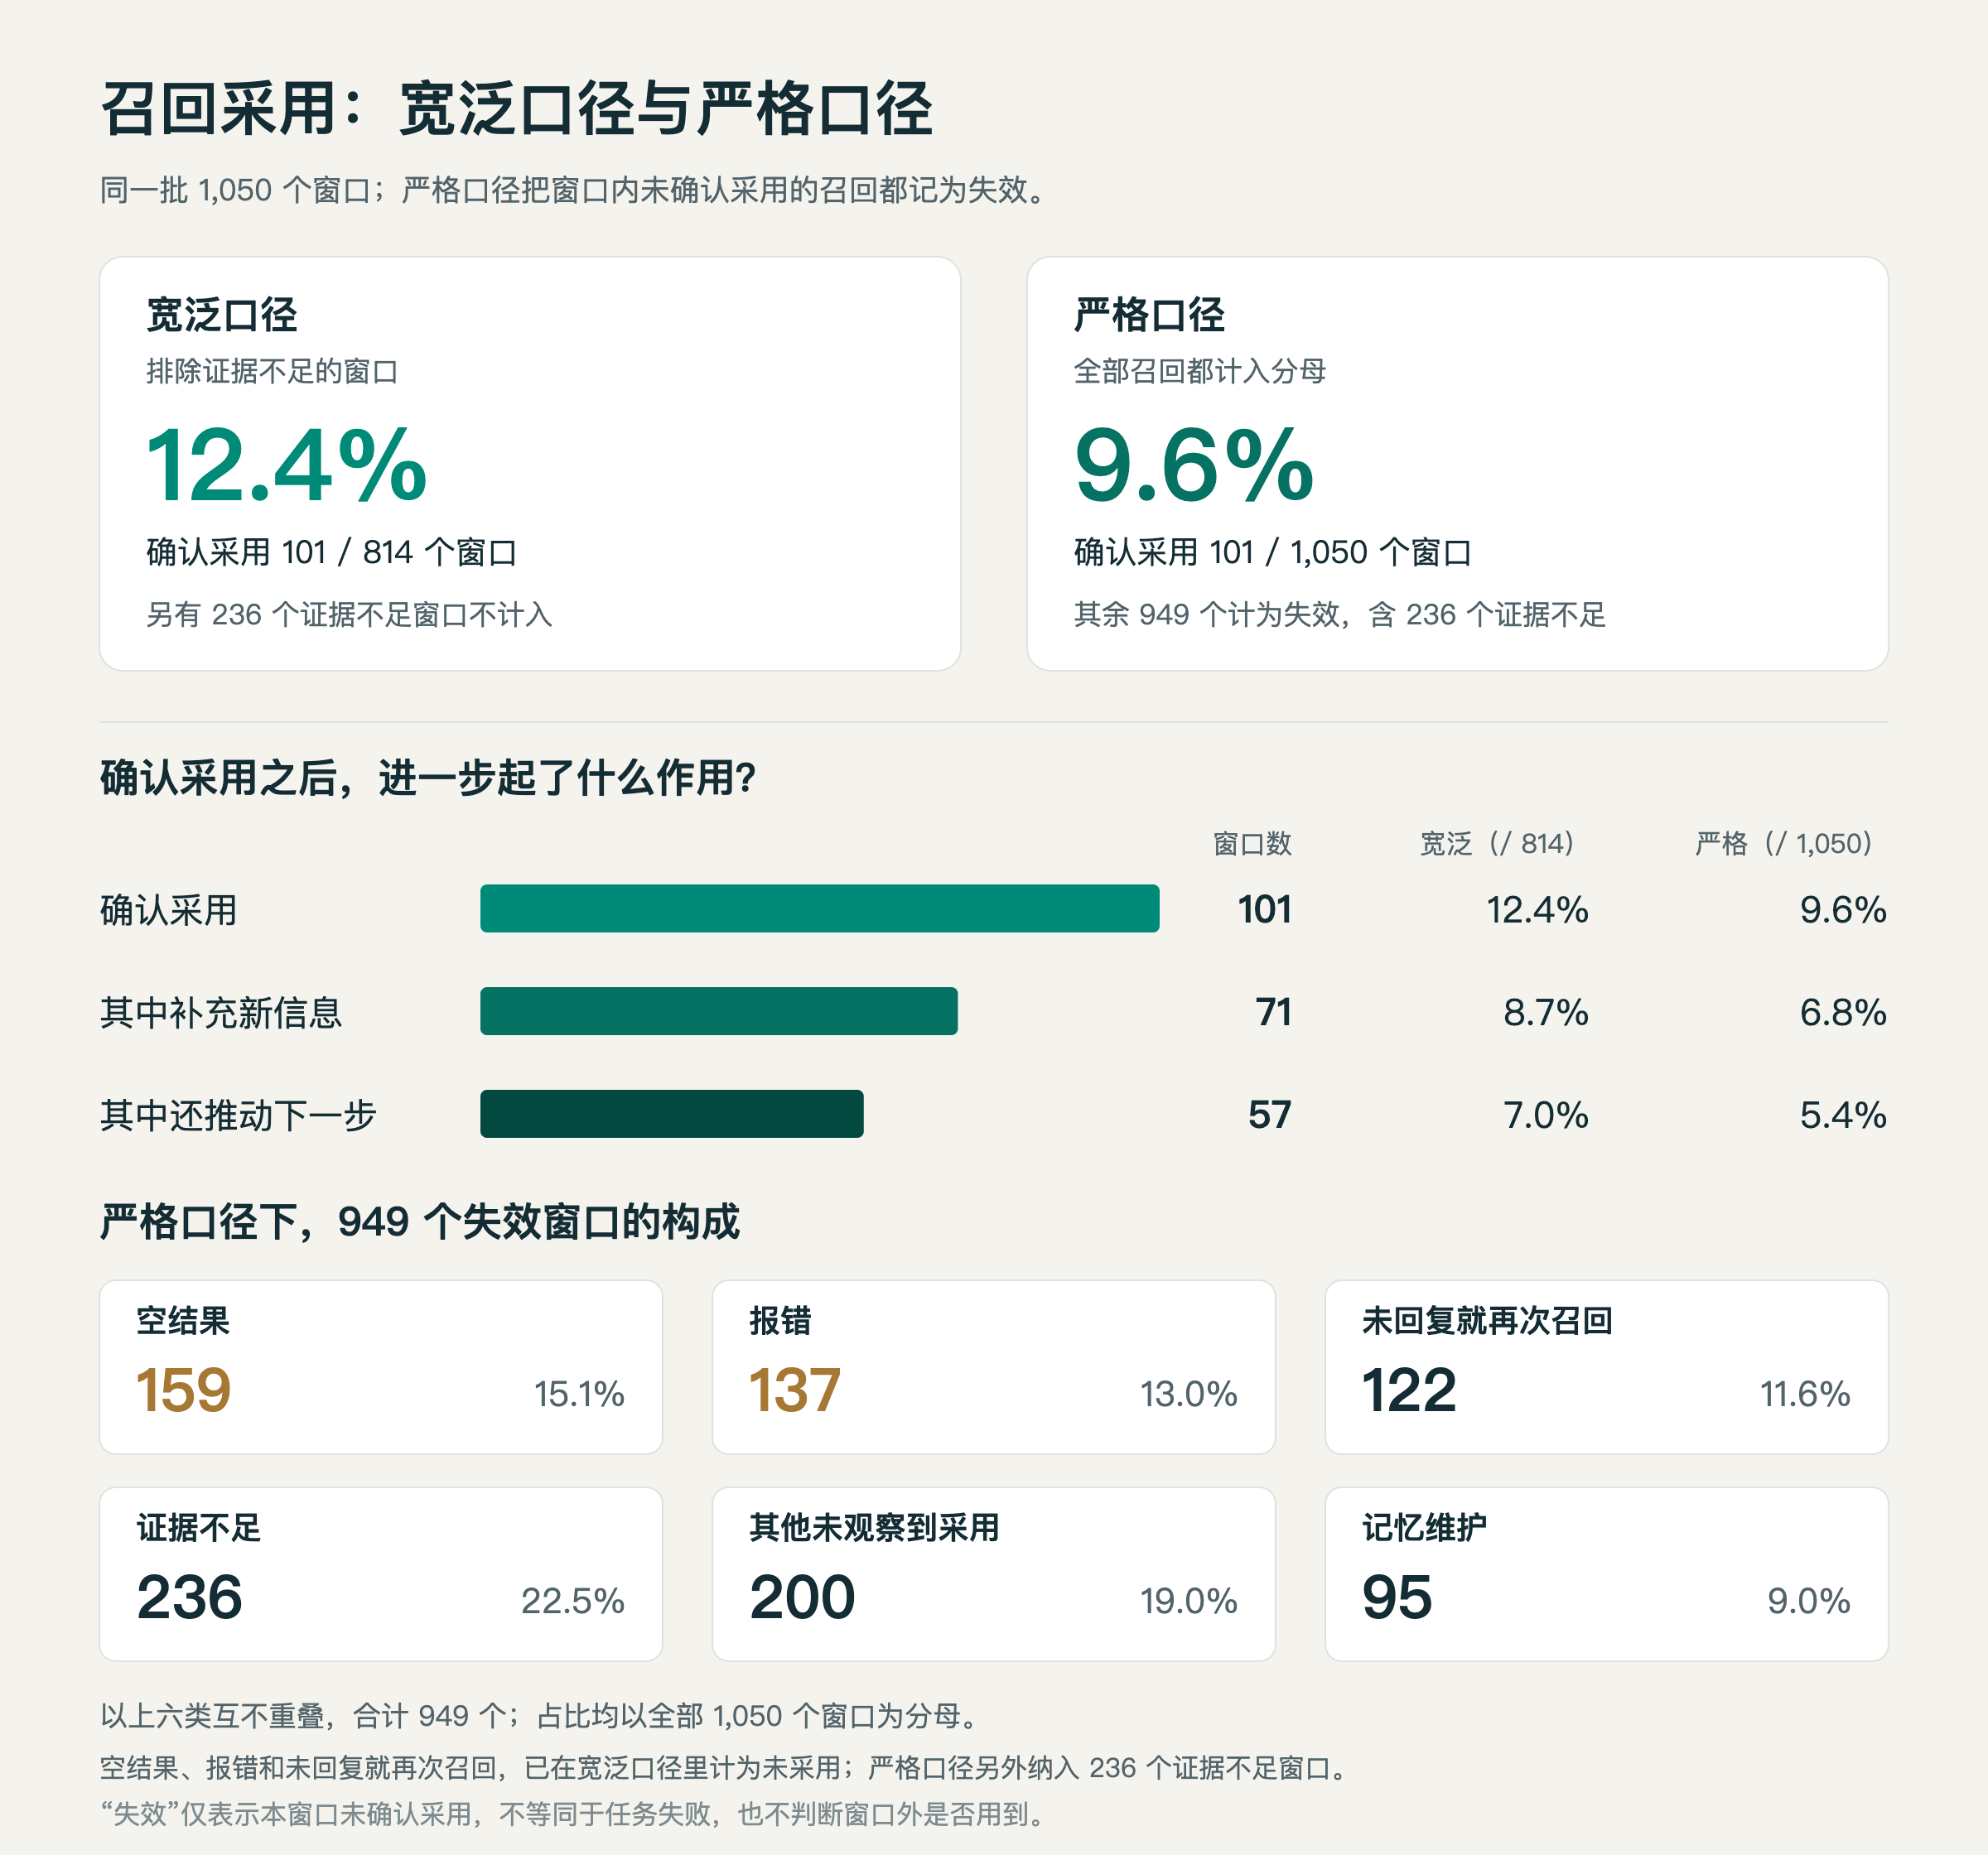
空结果和报错也占去了不少召回:159 个窗口为空(15.1%)、137 个报错(13.0%)(报错不能原谅啊,思为要加油了),合计占全部窗口的 28.2%;另有 122 个窗口在 Agent 给出可见回复前就发起了下一次召回(11.6%)。这三类原本就计入宽泛口径的“未观察到采用”,严格口径没有重复扣算。图中六类互不重叠,合计是 949 个严格口径的失效窗口。
已识别知识正文中,12.6% 的 token 属于重复返回。空结果可能正确地表示没有相关记录,连续查询和重复返回也可能用于继续调查或确认;按规则计为未采用,并不意味着这些召回都没有意义。
返回成本则提供了另一个角度:在 677 个可判断、且返回量能够归属的窗口里,把总返回量除以其中 101 个确认采用窗口,折算约 13,664 token / 次。其中,54.2% 的返回 token 落在“未观察到采用”的窗口。这个占比按 token 数量计算,与前面的窗口采用率衡量不同对象;折算返回量也不是单条有效记忆的长度或 API 账单。
这些结果让我开始怀疑当前用法的效率,也想继续检查查询时机、返回长度,以及这些内容有没有提供当前缺少的信息。
结合上面两点,约一成的召回能确认被用上,我觉得还算可以;但记忆相关内容占上下文的中位数约为 4%,确实比我想象的多了一点。我原本希望,记忆能用比较少的 token 带回关键信息,推动一些重要决策,也可能是我的期望或用法需要调整。
另外,这次还没有统计“该找却没找回”的情况:任务需要的信息明明已经在记忆里,Agent 却没有发起搜索,或者搜了也没有找到。如果以“是否找回本该用到的记忆”为判断标准,这属于漏召回,也就是假阴性。现有采用率只统计已经发生的召回,没法告诉我们有多少次记忆本该帮忙却没有出现。要判断整体效率,这一部分也需要算进去。
有效召回分析
然后我们分析这些确认用上的召回:带回了什么,又是在什么情况下被用上的?先看被采用记忆的类型,再比较检索工具、Agent、工作场景,以及查询方式和记忆来源。类型分析只看确认采用的记忆;后面的采用率比较,则会把采用与未采用的召回放在一起看。
被采用的记忆里,事实和决定比流程多
我又按 Nowledge Mem 在原始返回里的 unit_type 分类,统计了被采用的记忆。101 个确认采用窗口中,62 个能完整追溯到原生类型,涉及 69 条去重记忆,共有 103 次条目采用。
其中,事实(fact)33 次、决定(decision)30 次,合计 63 / 103 次,占 61.2%;流程(procedure)12 次,占 11.7%。在这批可追溯的采用记录里,事实和决定相对多,经验和流程相对少,这跟我的直觉相反,我以为经验和流程的记忆会被使用更多。
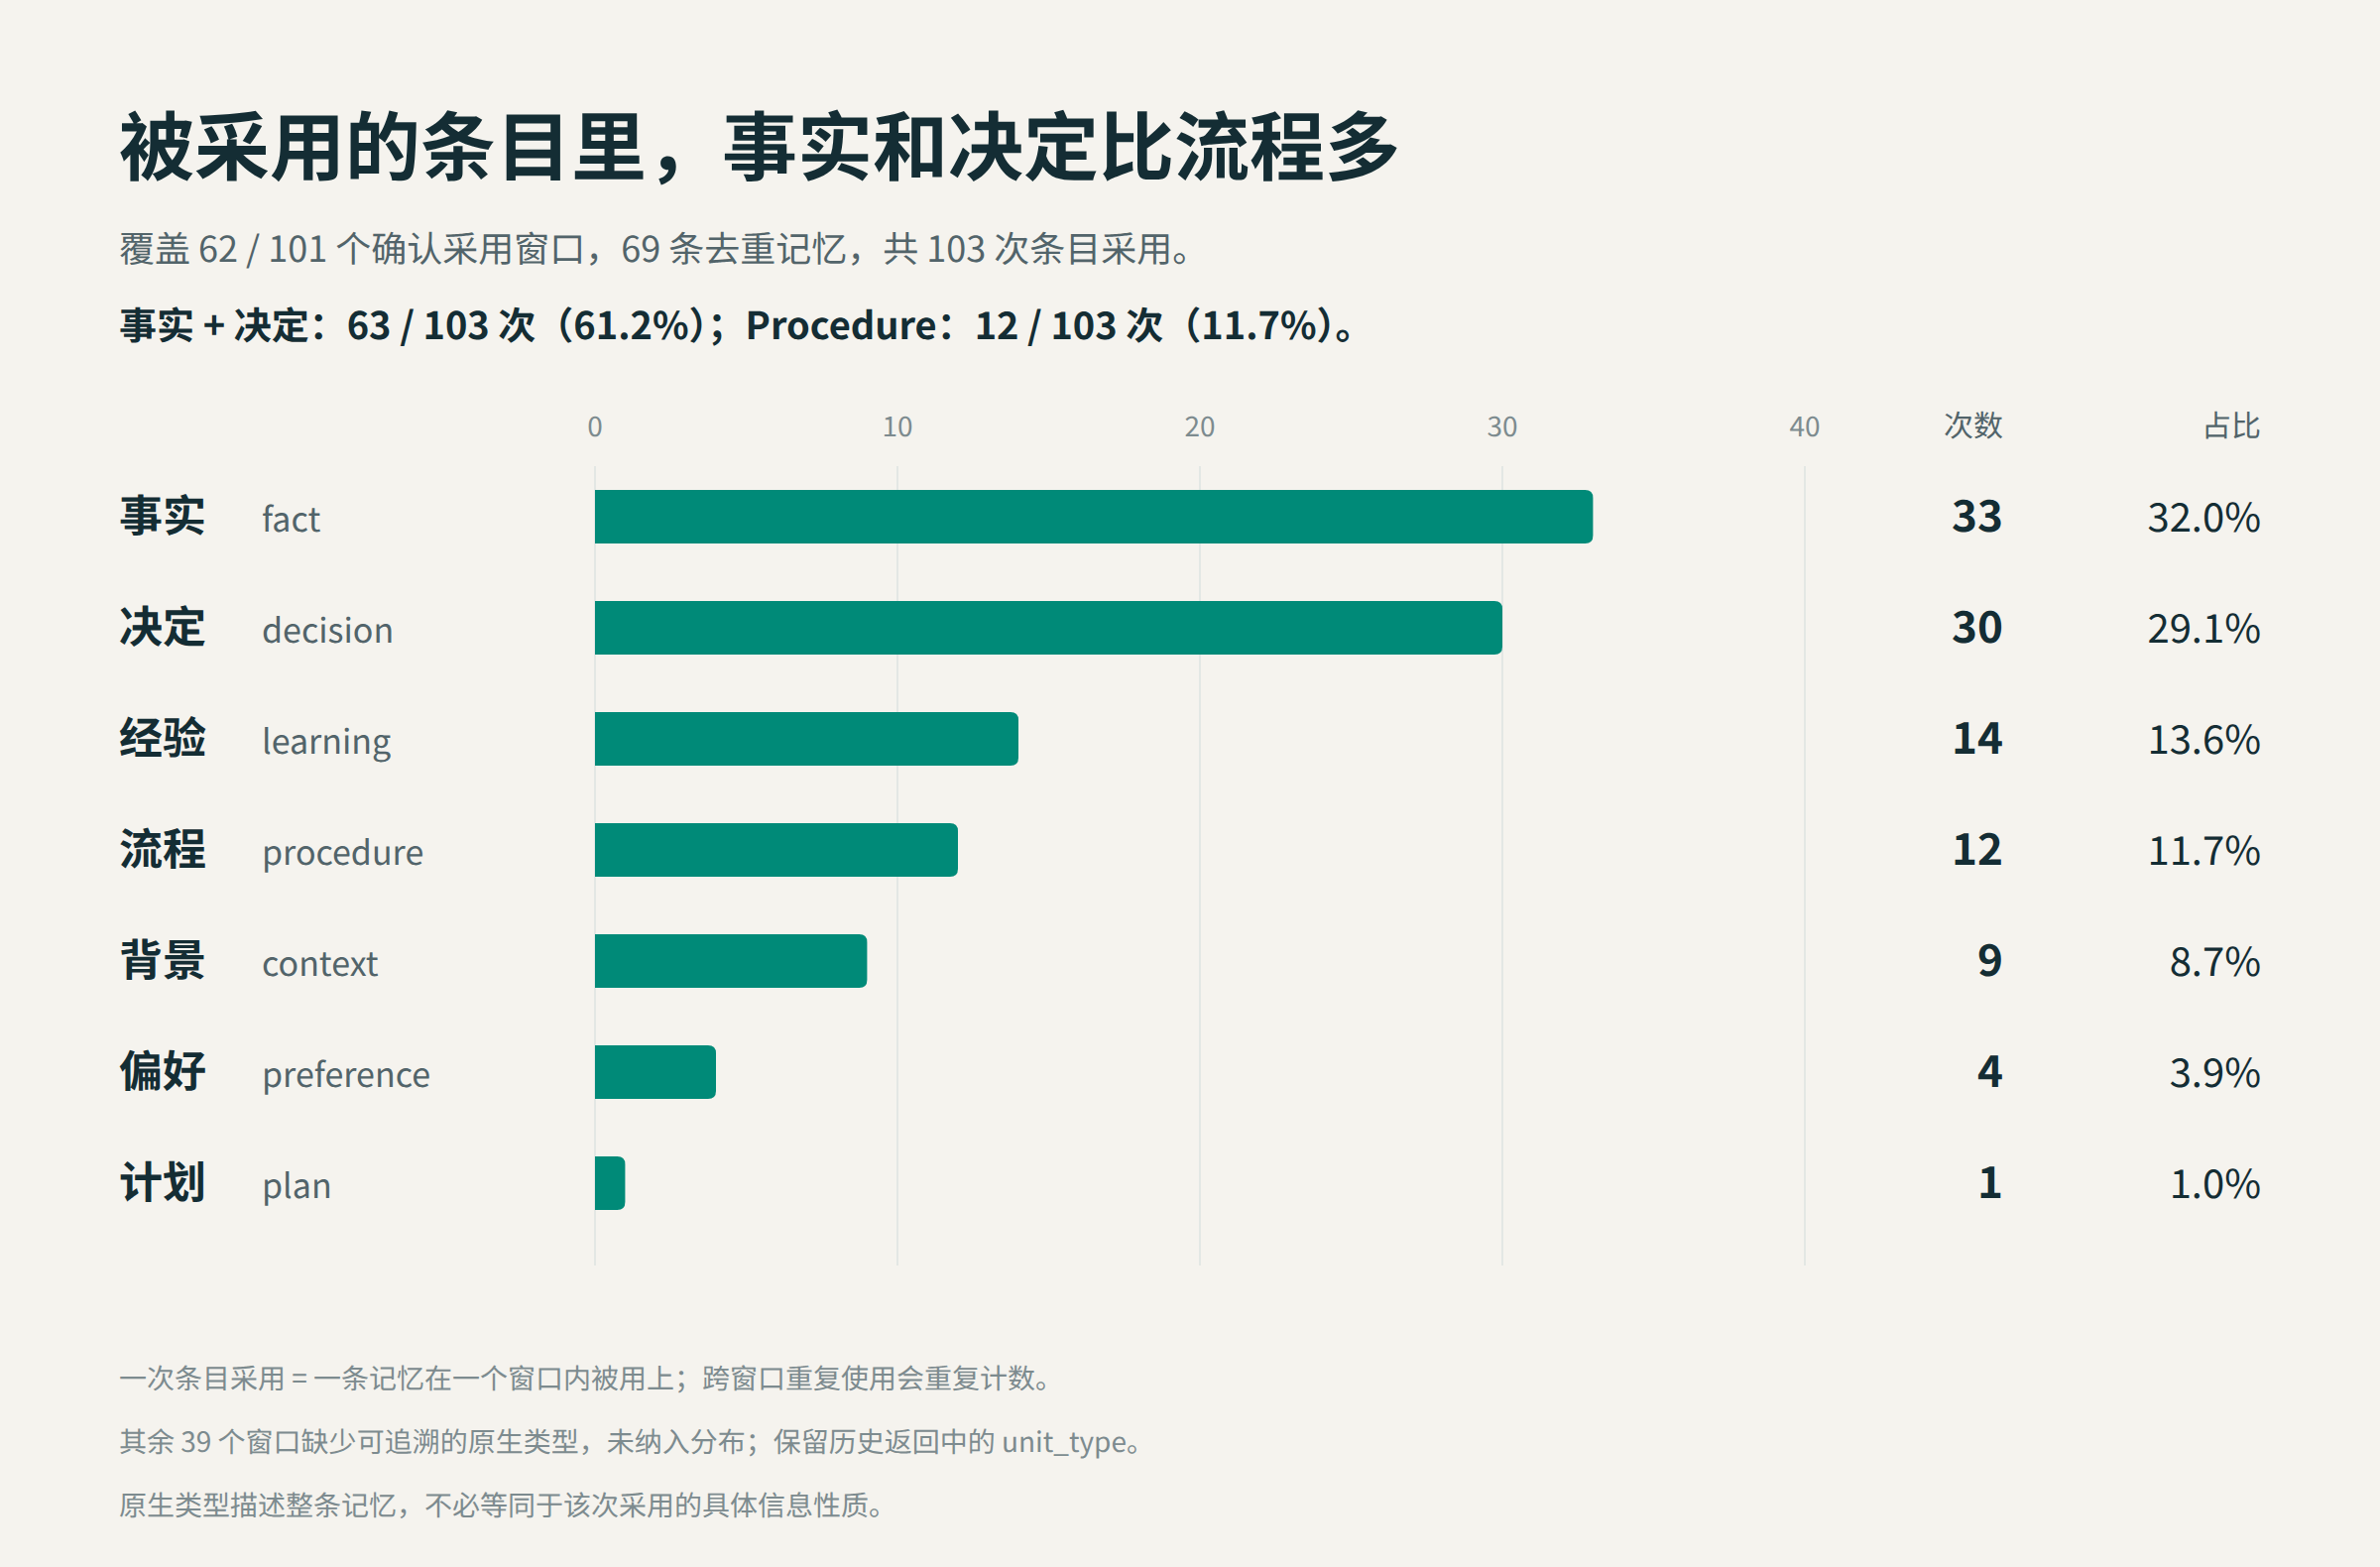
这里一次“采用”指一条记忆在一个窗口内被用上:同一条记忆跨窗口使用会重复计数,一个窗口采用多条记忆则分别计数,占比以 103 次为分母。其余 39 个窗口缺少可追溯的原生类型,没有纳入类型分布,其中包括 Claude Code 的 2 个:返回被脚本改写成了标题加正文,类型没有保留下来。
这些类型是系统给整条记忆打的标签,不一定等同于每次实际用到的信息性质,也不能据此推断整个记忆库的构成。
搜记忆比搜历史会话,更容易拿到可直接使用的信息
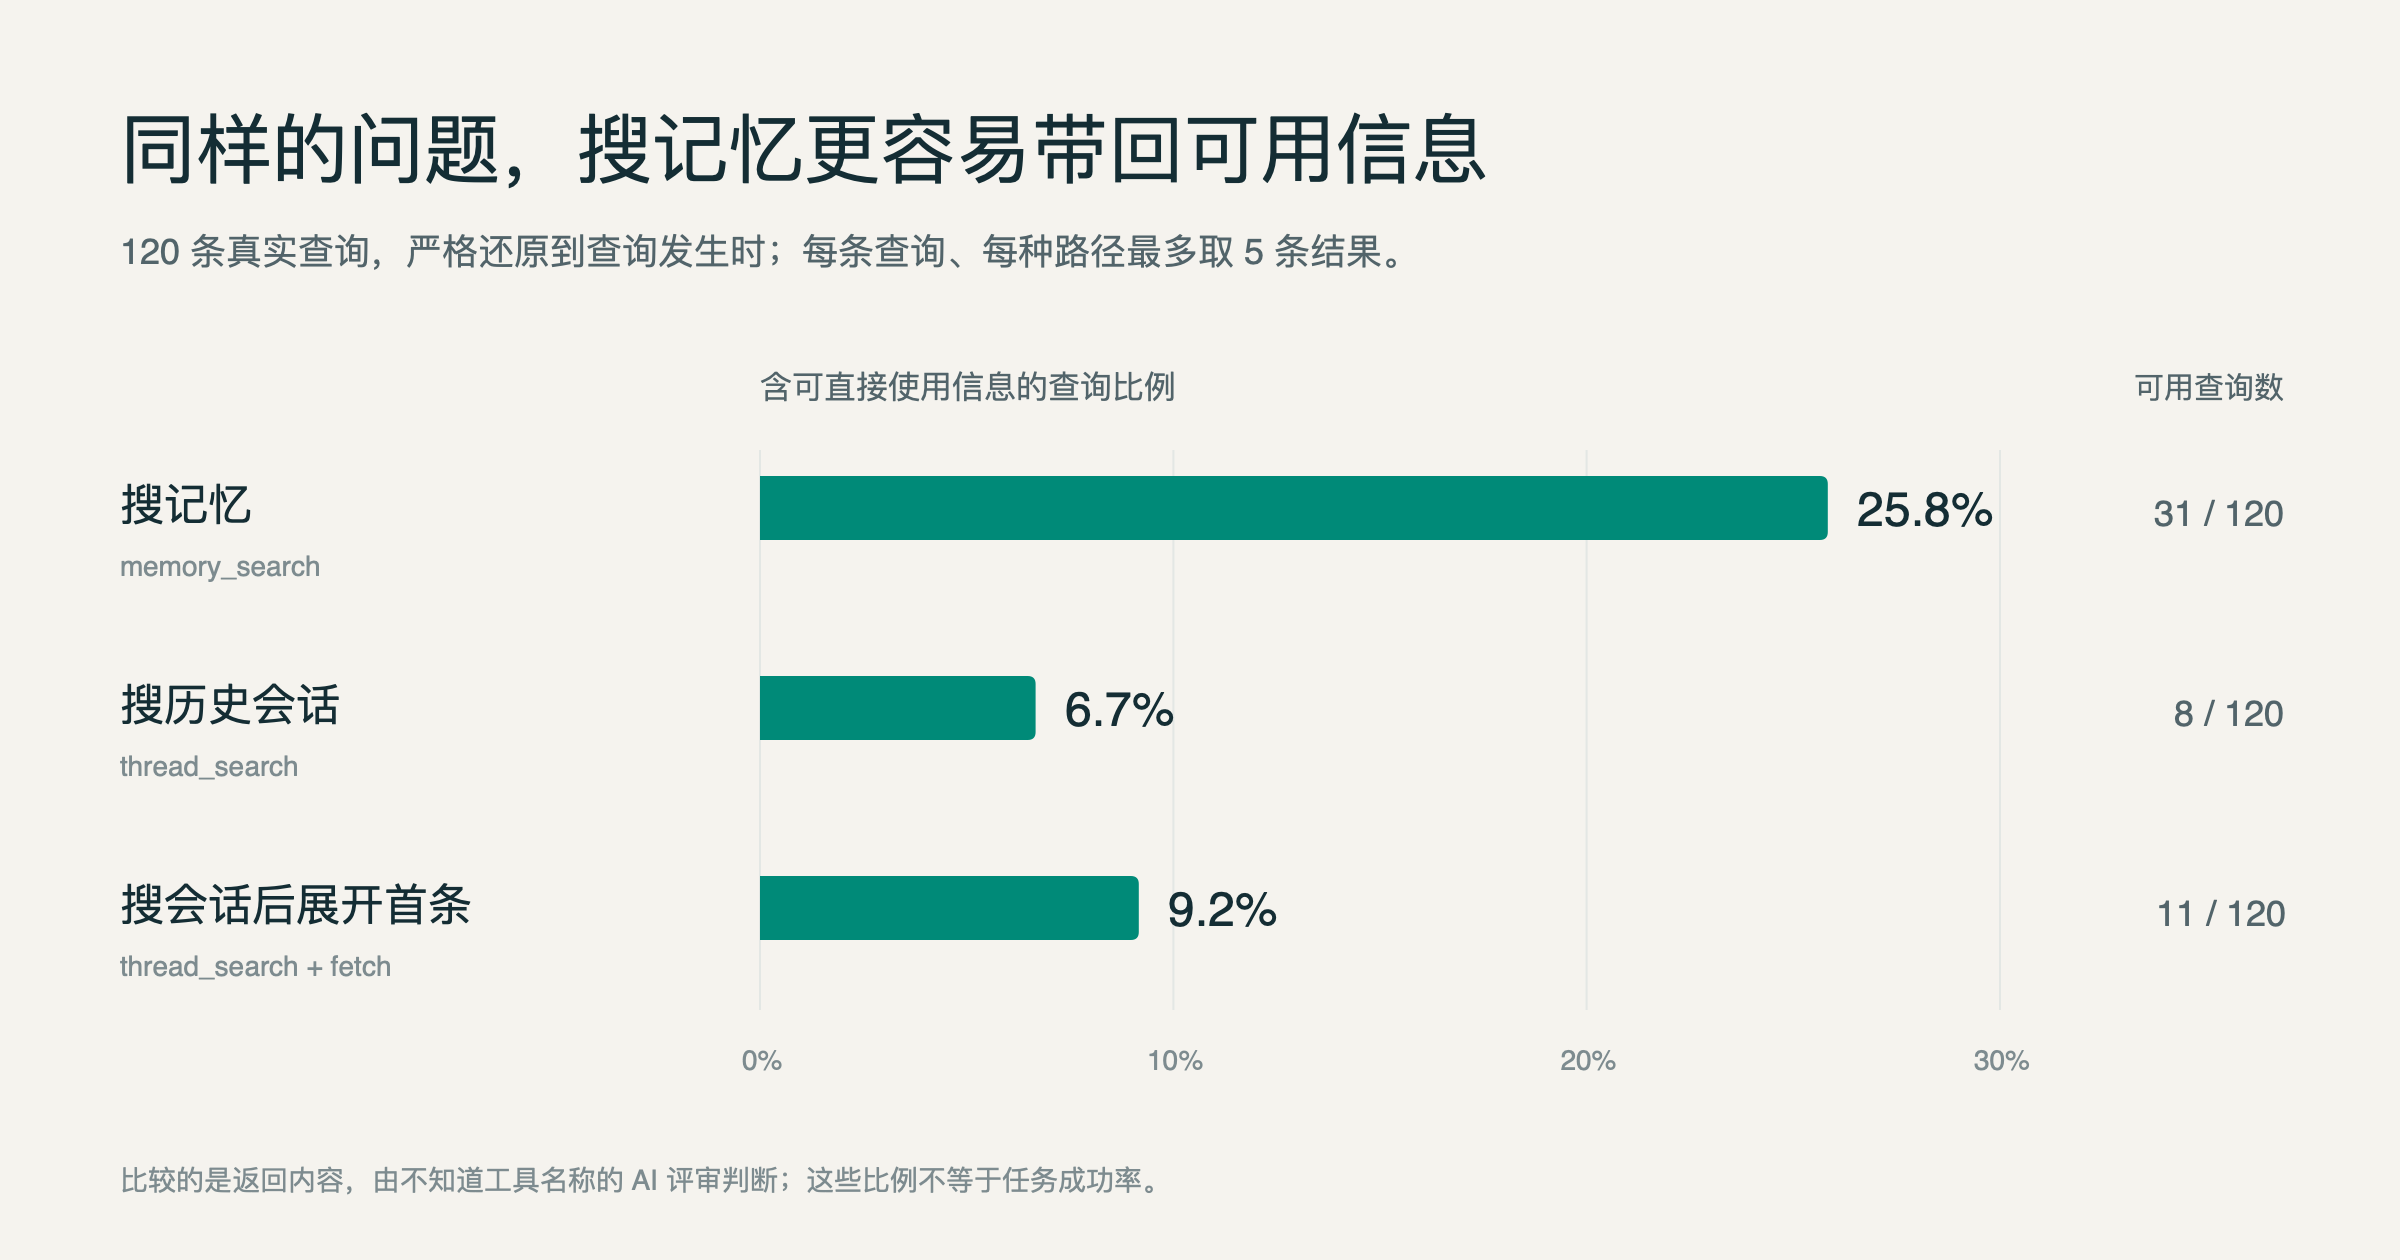
同一批 120 条真实查询,严格还原到查询当时后,搜记忆有 25.8% 的查询含可直接使用的信息,搜历史会话是 6.7%。搜会话虽然单次更快、返回更少,但按每获得一次可用结果折算,返回量反而更多。在这批任务里,我会优先搜记忆。
不同 Agent 主动搜记忆的积极性,差别很大
把接入后的会话按 Agent 拆开,差别比我预想的大。这里只统计接入 Nowledge Mem 之后、有我输入提示的主会话,所以 Claude Code 是 151 个,比后面单独分析 Claude Code 自动注入时的 162 个少 11 个。
- Codex 最积极:每 100 条提示对应 94 次召回,170 个会话里 88% 搜过记忆,而且几乎都是它自己发起的。但它的采用率只有 9.1%(56 / 617),是几个 Agent 里最低的,空结果和报错还占了 31%。
- OpenCode 搜得少一些,采用率最高:每 100 条提示 12 次召回,35% 的会话搜过记忆,采用率 29.1%(30 / 103)。
- Hermes、Kimi Code 和 Claude Code 很少主动搜:每 100 条提示只有 1.7 到 7.6 次召回,搜过记忆的会话都不到一成。它们的召回里,有一半左右发生在我提到“记忆”或 Nowledge 之后,Codex 只有 2%。
其实除了 Codex 以外,其他的 harness 都不太会主动去做记忆的搜索,我必须得去主动提,这也会导致整体的采用率比 Codex 高,因为我是明确知道有什么东西被存在了记忆里面。
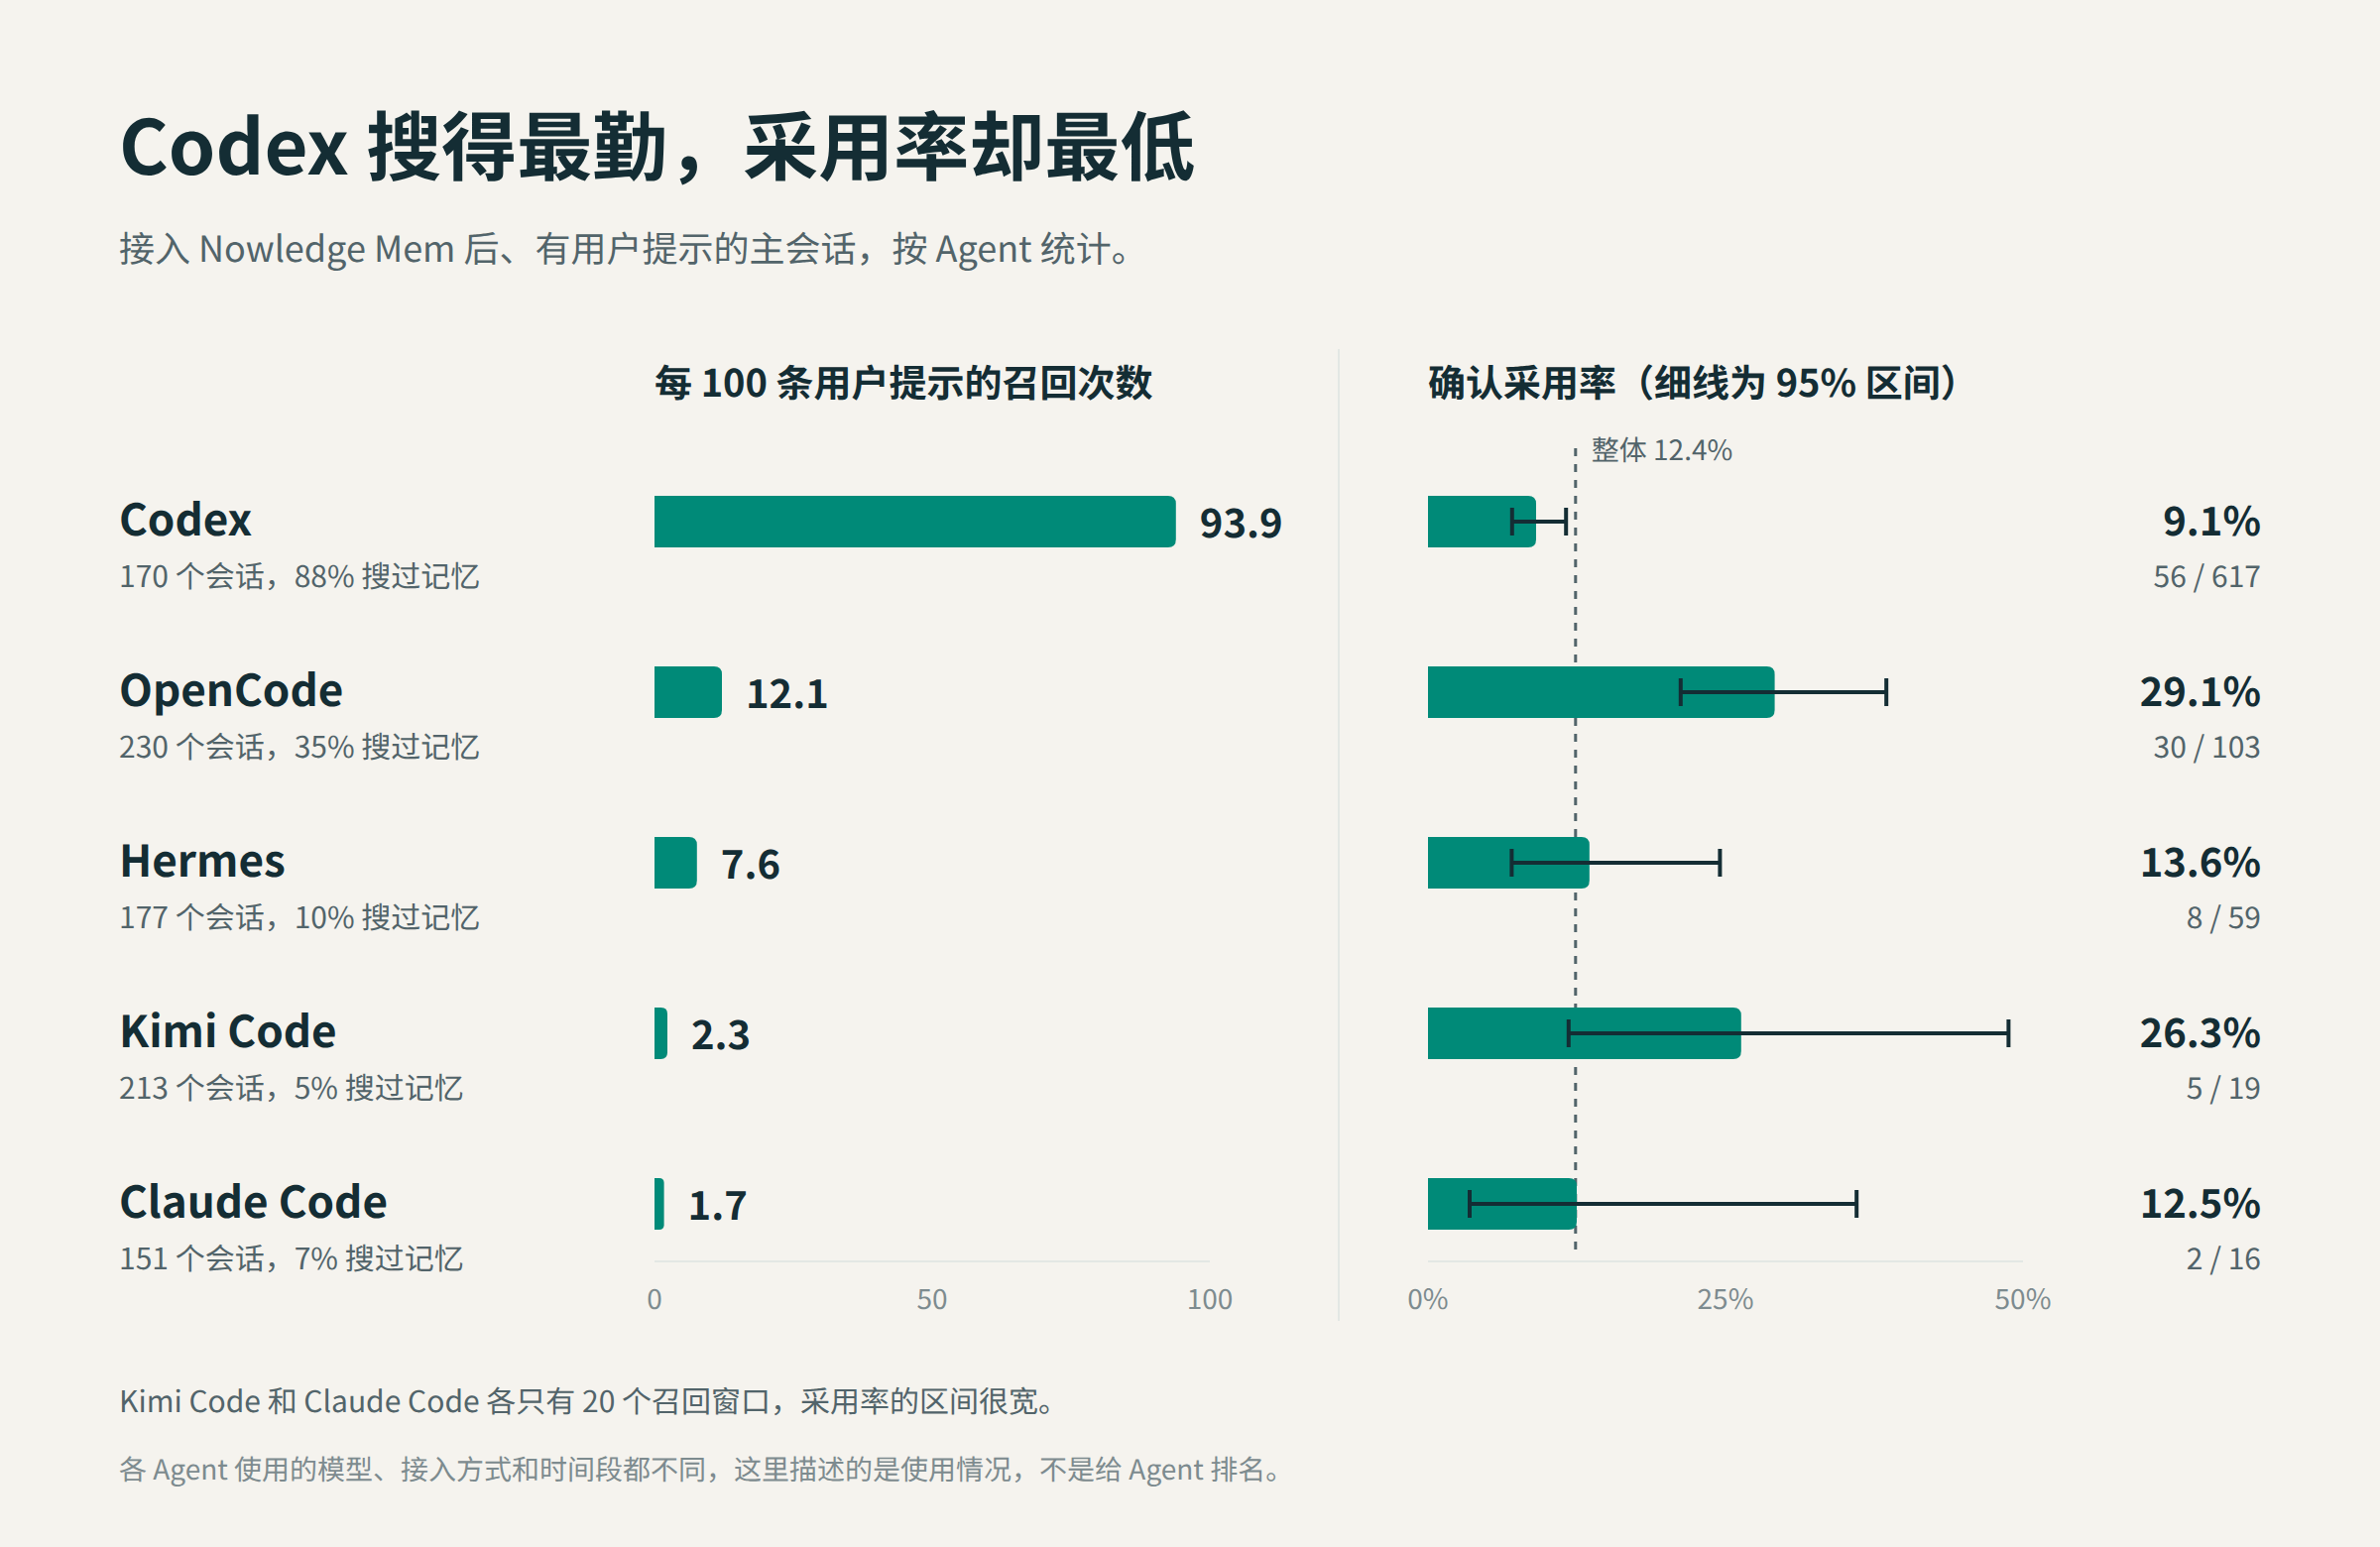
搜得勤也不全是浪费。按每 100 条提示折算,Codex 确认用上的召回有 6.4 次,OpenCode 2.8 次,其余三个都不到 1 次。Codex 的插件会在系统提示里要求:遇到延续、复查、历史决定这类工作,下结论前先搜一次 Nowledge。Claude Code 的插件每次提交消息也会提醒搜索,但它主动搜的很少。
这几个 Agent 用的模型不同:Codex 是 GPT,OpenCode 主要是 GLM、MiniMax 和 Qwen,Hermes 主要是本地部署的 Qwen,Kimi Code 是 Kimi,Claude Code 是 Claude。接入方式和时间段也不一样,Kimi Code 和 Claude Code 又各只有 20 个召回窗口。所以这里描述的是我的使用情况,差别不能全算在 Agent 本身,也不是排名。
实验类工作搜得最勤,项目管理类最常用上
我一直把自己的工作负载说成“以 Coding 为主”。按会话的主要任务分一下,写代码确实最多,但只占四成:1,078 个会话里,编码开发占 43%,运维与环境 17%,调研 11%,写作与内容 8%;其余是 Agent 与记忆配置、个人事务与知识问答、闲聊与测试、产品与设计、项目管理与协作,以及研究与实验。不同 Agent 分到的工作也不一样:Claude Code 和 Kimi Code 六成左右是写代码(62%、57%),Hermes 几乎不写代码(1%),41% 是调研。
按工作场景拆开,召回频率和采用率都差得很多。召回频率按会话的主要任务统计,采用率按召回发生时我在做的事统计。
- 研究与实验搜得最勤,用上的最少:每 100 条提示有 117 次召回,几乎都在 Codex 里(218 / 219)。返回的内容多半和任务相关,采用率却只有 5.1%(7 / 136)。
- 项目管理与协作最常用上:采用率 21.7%(13 / 60)。按提示折算,每 100 条有 18 次确认用上的召回,其他场景都不到 4 次。建 ticket 的格式、看板归属这类约定,正好存在记忆里,也是各种经验和流程。
- 运维与环境的采用率也高:21.6%(24 / 111),主要来自 OpenCode 等 Agent;Codex 的运维召回只有 6.1%(3 / 49)被用上。
- 写代码在中间:每 100 条提示 17 次召回,采用率 10.3%(19 / 184)。
- 检查、安装和配置记忆系统本身的 33 个窗口,一个也没有确认采用:其中 27 个发生在 Hermes 里。
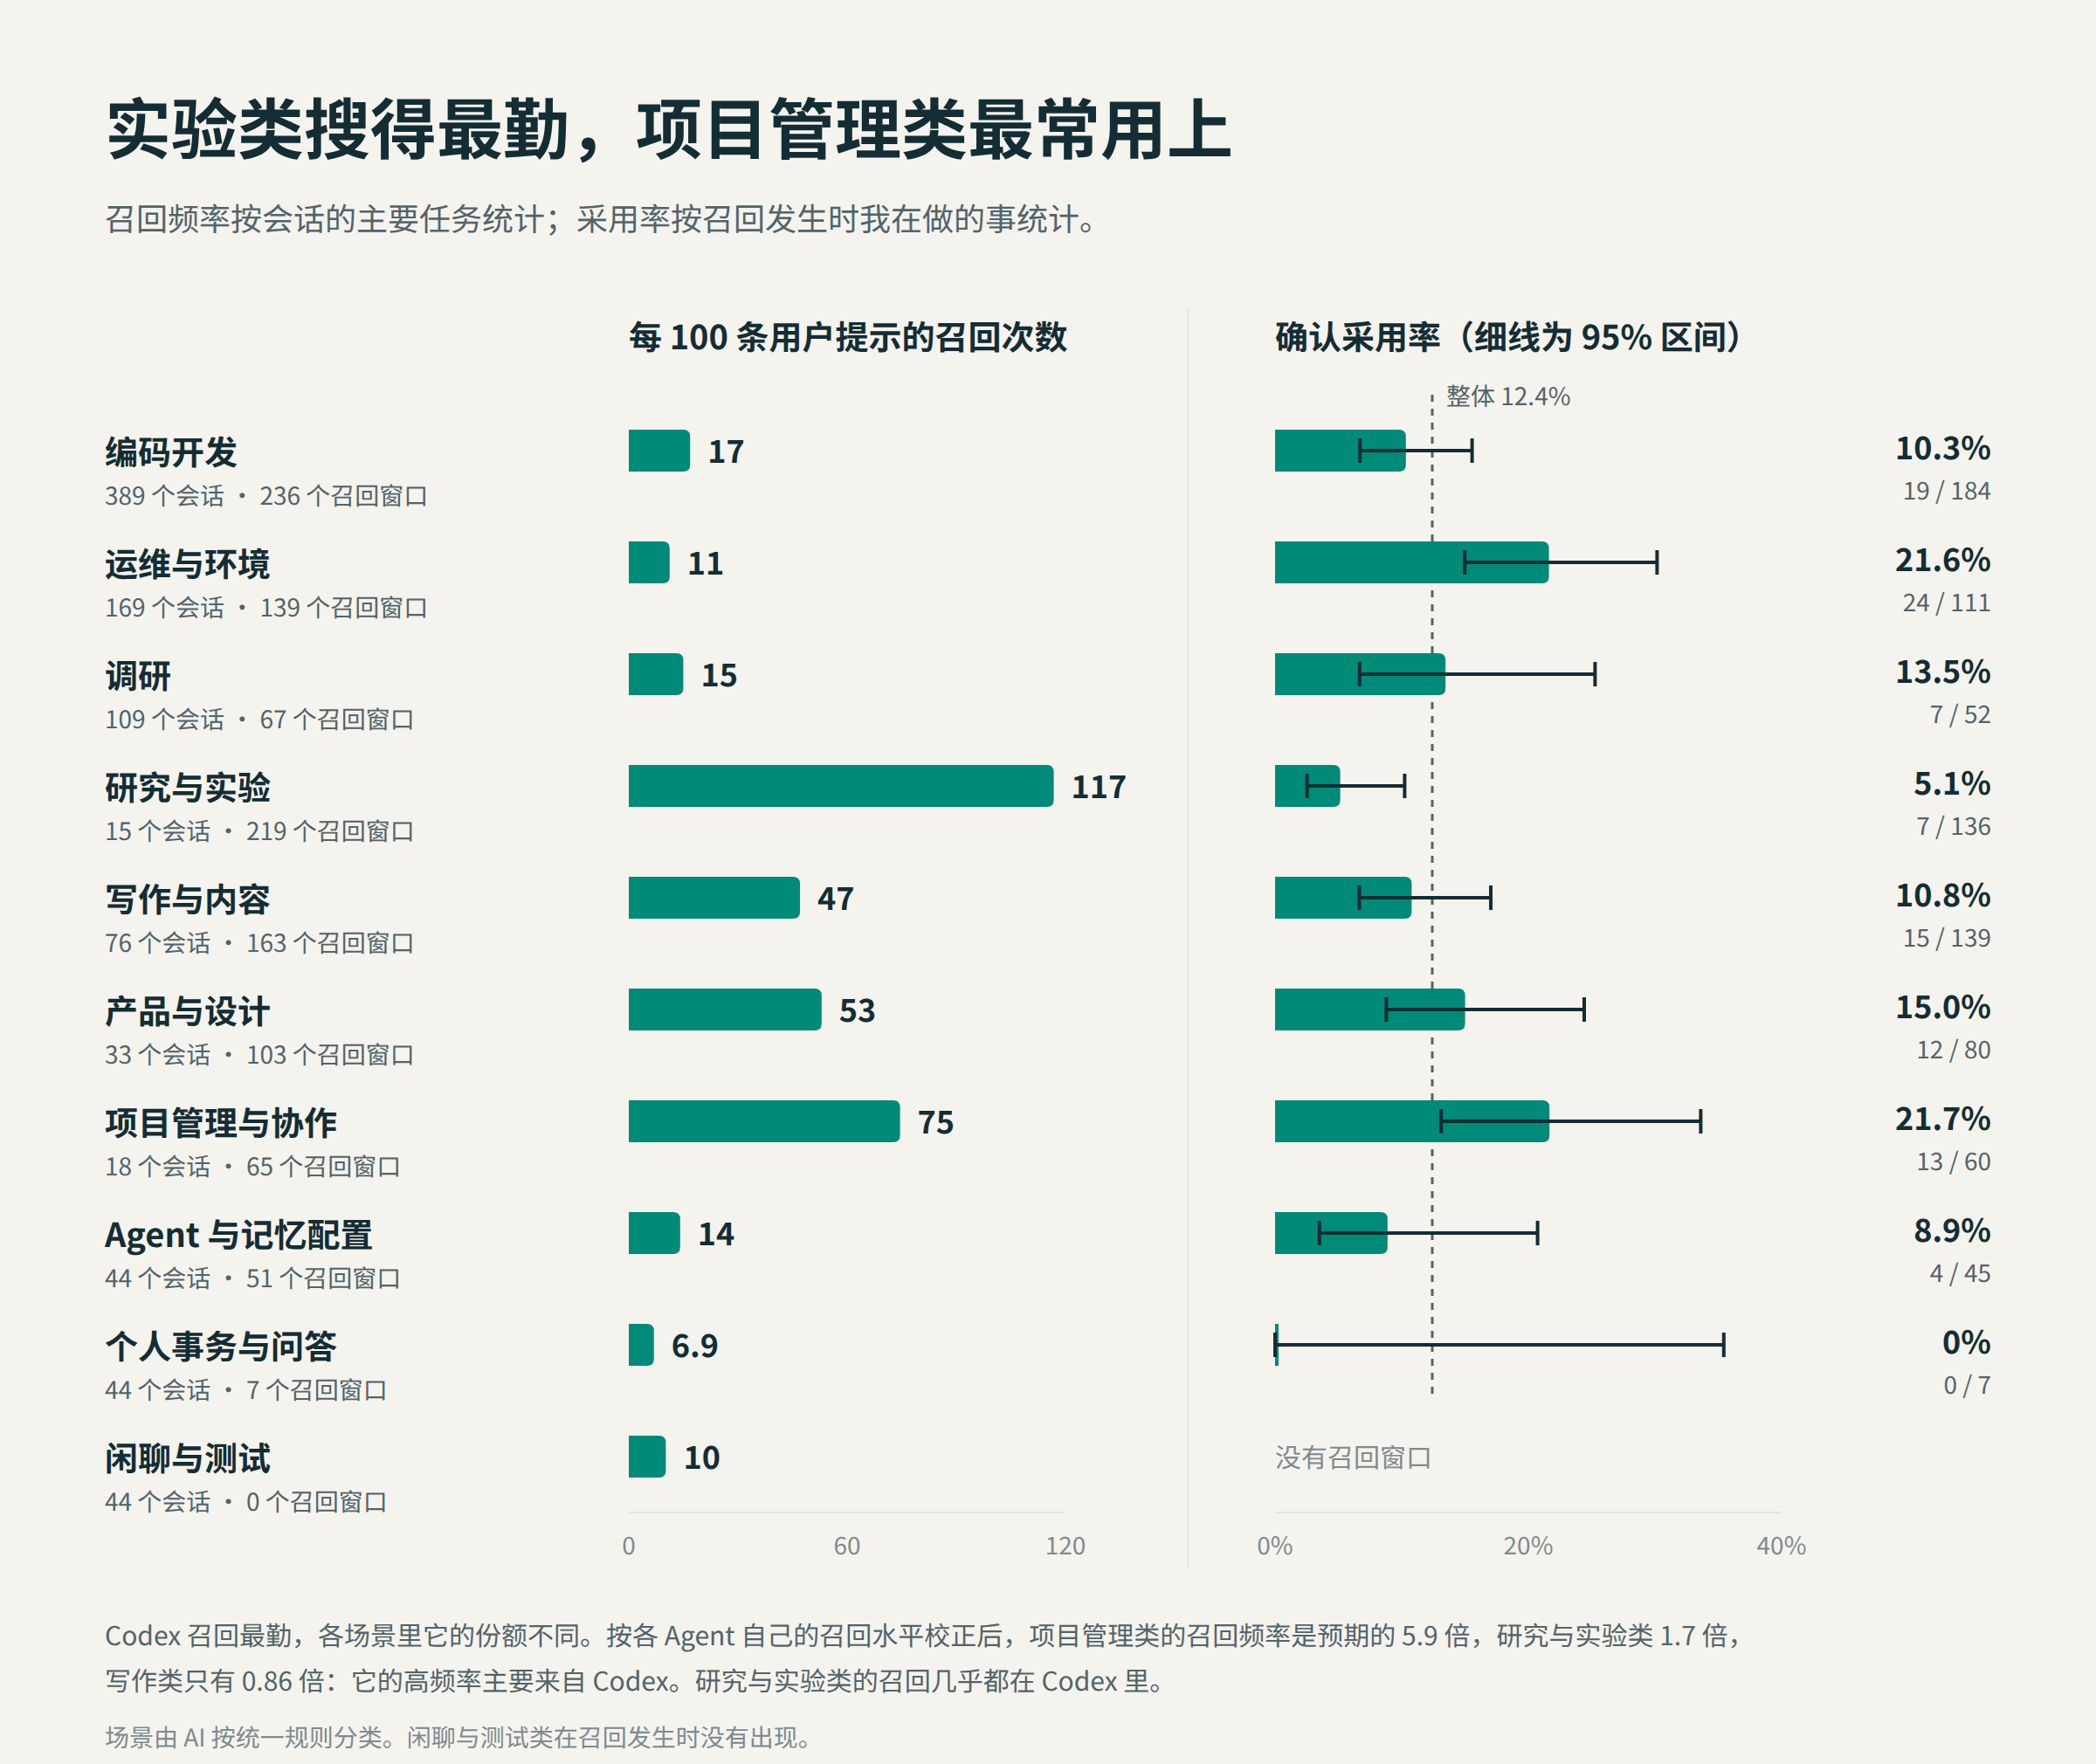
场景和 Agent 是缠在一起的:Codex 召回最勤,它的工作又偏写作、产品和研究。按各 Agent 自己的召回水平校正后,项目管理类的召回频率仍是预期的 5.9 倍,研究与实验类 1.7 倍。各场景的窗口数不多,这些差别只说明我的使用情况。
第一次召回和写得具体的查询,更常被用上
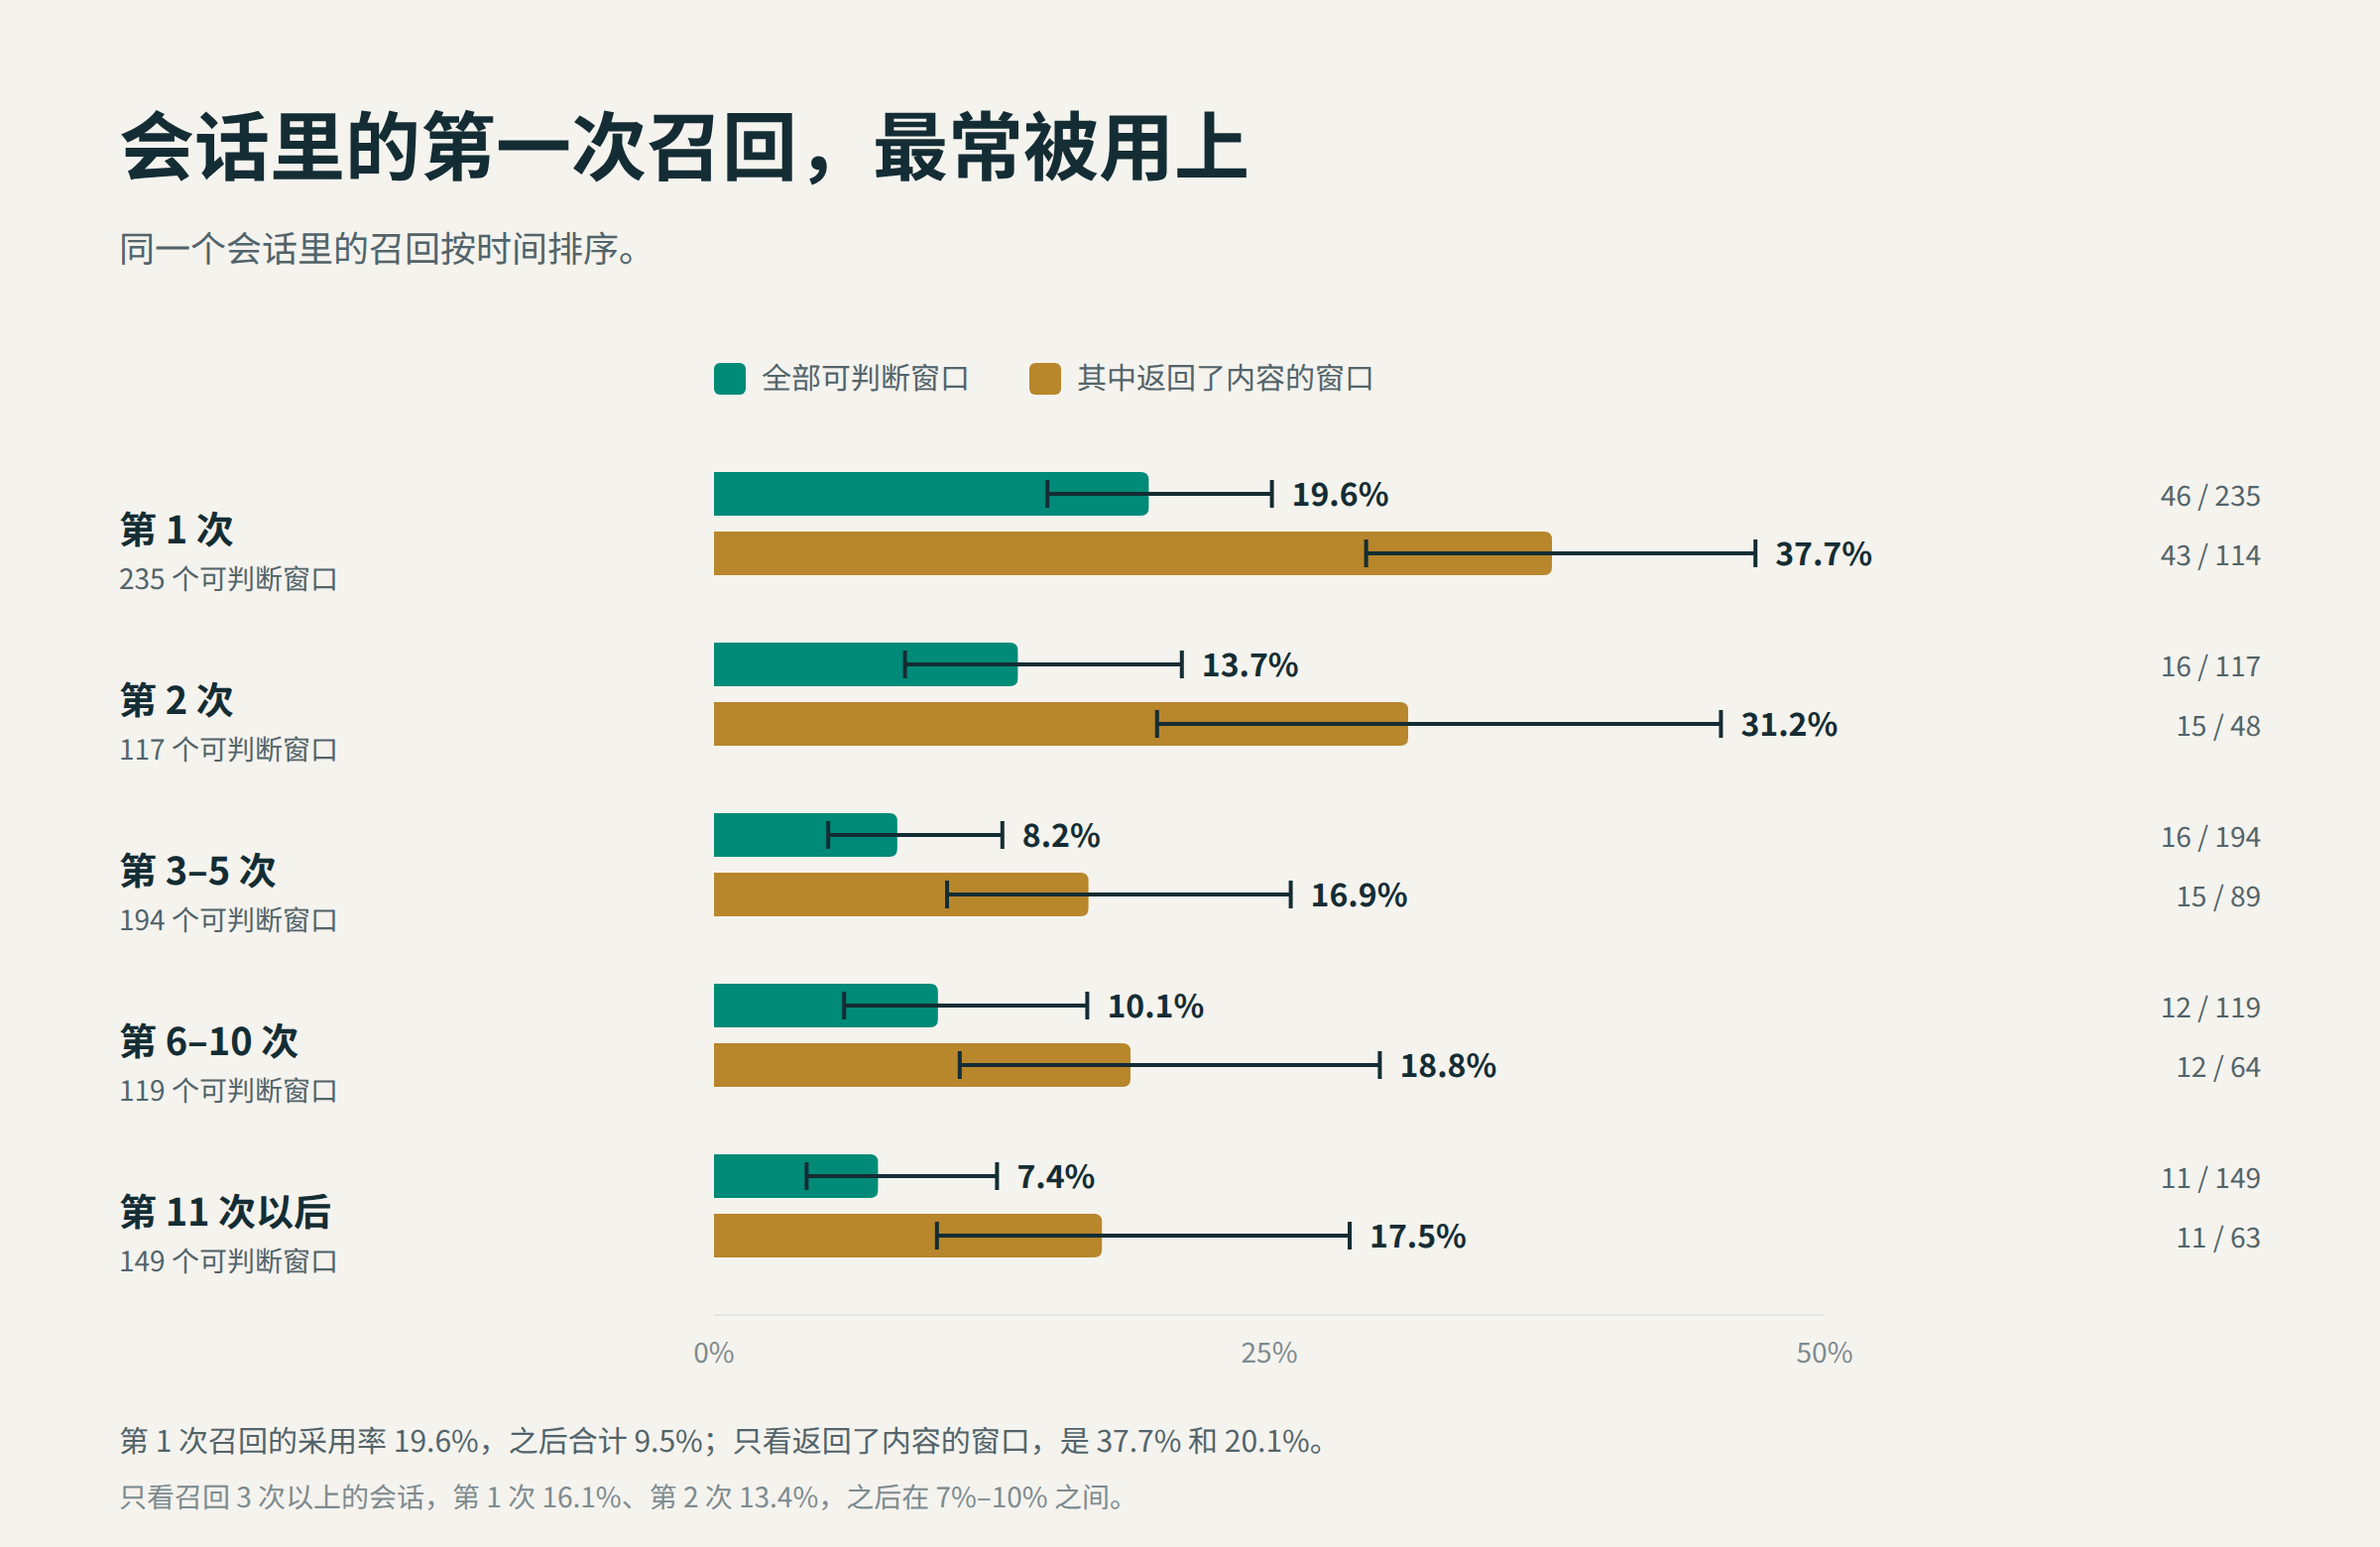
把同一个会话里的召回按时间排序,第一次召回的采用率是 19.6%(46 / 235),之后合计只有 9.5%。这不全是空结果造成的:只看返回了内容的窗口,第一次是 37.7%,之后是 20.1%。第一次召回多在任务开头,可能正是最需要背景的时候;如果只查一次,任务开头也许最值得查。这个发现我个人觉的很有意思啊,如果是我做 Prompt 优化的话,我可能会倾向于让 Agent 直接再前两轮收集齐所需要的记忆数据,再中途不必再召回,只做记忆的更新即可。
查询写得越具体,越容易用上。15 个字符以内的查询,60 次里只有 2 次被采用(3.3%),其中 36 次只拿回了标题;60 个字符以上是 18.2%(30 / 165)。分开看也一样:Codex 从 15 个字符以内的 0 / 45,升到 60 个字符以上的 14.3%;其他 Agent 从 13.3% 升到 34.4%。
返回得越充分,越常被用上,但用上的多是前几条。返回量最多的四分之一窗口,采用率 39.4%,最少的四分之一是 12.8%。单看每个条目,排第 1 的条目 12.6% 被采用,第 6 条以后只有 3.8%;排在前 3 位的条目,占了被采用条目的 75%。
搜空或报错之后马上再搜,多半没用。搜空之后,同一会话里又召回了 123 次,几乎都换了查询,仍有 40% 为空,全部召回里这个比例是 15%;确认采用的只有 6 次。报错之后的 104 次召回里,59% 还是报错。遇到这两种情况,先接受“没有”,或者先查报错原因,可能比连续重试更省事。
新写的、同一个 Agent 留下的记忆,更常被用上
把返回的每条记忆,按它在日志里第一次出现到这次召回隔了多久分组:不到 1 天的,16.1% 被采用;30 天以上的只有 6.0%。按创建时间算,结论相同:能查到创建时间的 88 次采用里,记忆写下的时间中位数约在 1 天前,78% 不超过一周。在我的使用里,记忆最常起的作用,像是前一个会话交给下一个会话的交接:刚做完的决定、刚定下的约定。
我的几个 Agent 共用一个记忆库。按记忆在这次召回之前第一次出现在谁的会话里分组:来自同一 Agent 其他会话的,14.7% 被采用;来自其他 Agent 会话的只有 6.0%,而这类条目占了返回记忆条目的 32%。分 Agent 看也一样:Codex 13.8% 对 3.7%,OpenCode 16.7% 对 8.8%,Hermes 12.0% 对 3.8%。
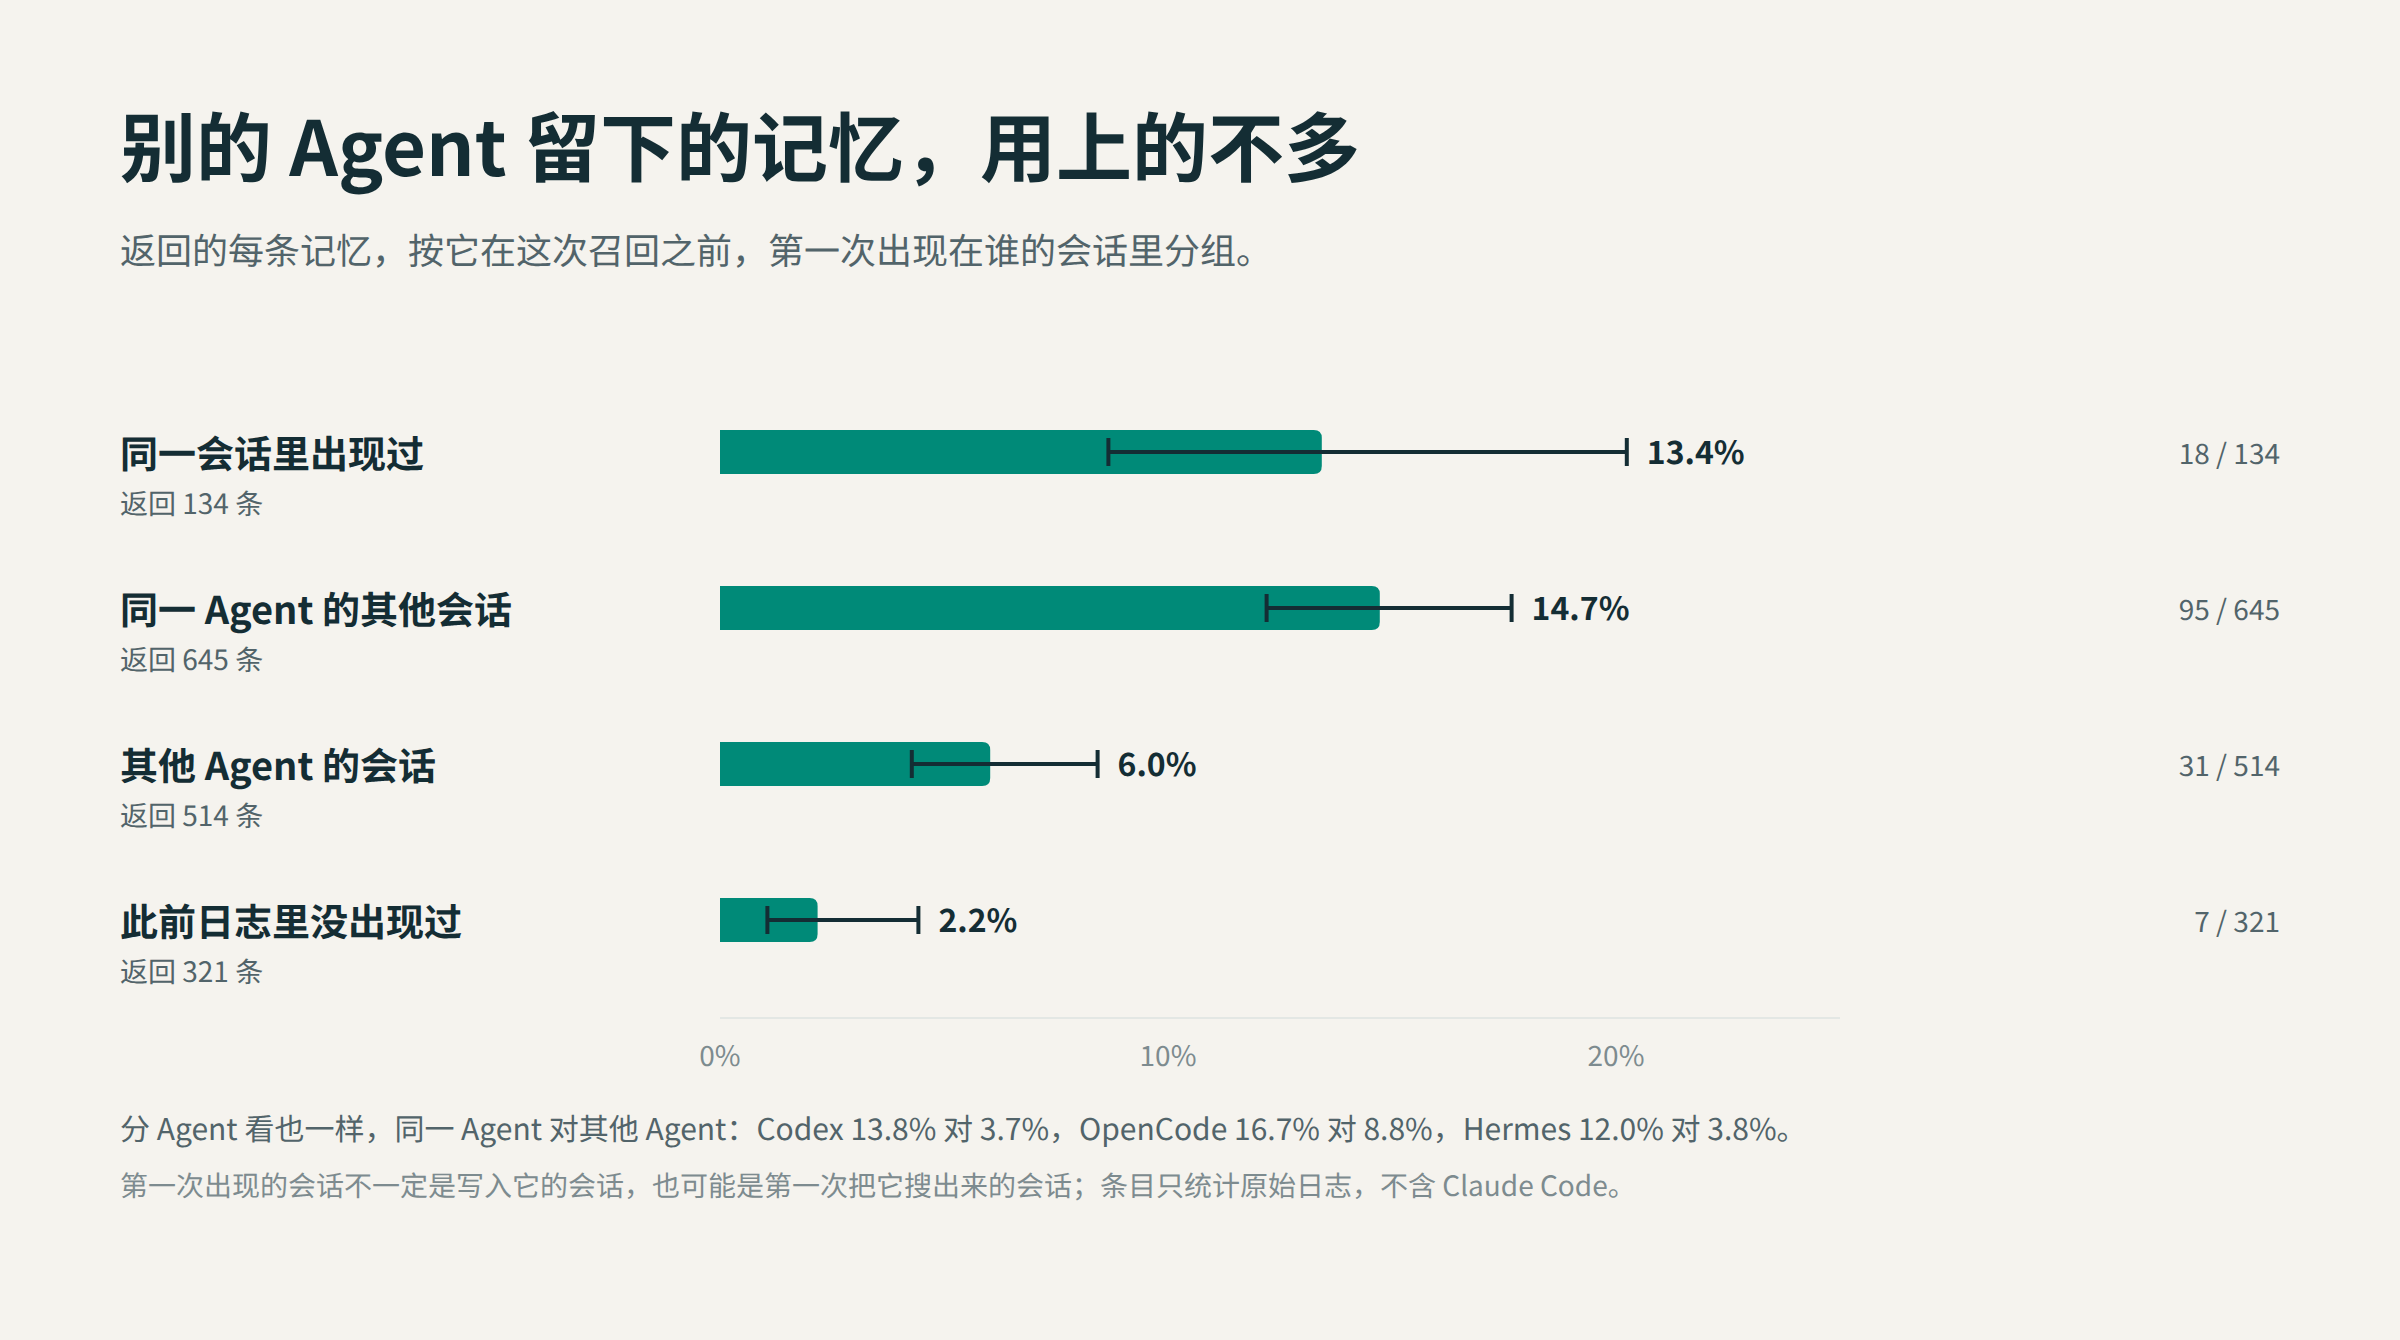
跨 Agent 的复用确实有:108 条被采用的记忆里,有 11 条被两个以上的 Agent 用上过,多是 GitHub issue 和项目看板的操作约定,以及云迁移、网络和集群的运维决定。一个可能的原因是,不同 Agent 做的事本来就不一样,别的 Agent 留下的记忆,常常属于另一个项目。这里的年龄和来源,都按记忆在日志里第一次出现推算,不一定是写入它的时间和 Agent。
其他发现
除了主动召回的采用情况,还有两点值得单独看:记忆如何被自动带进会话,以及带回来的信息是否仍然适用。
Claude Code 里,记忆主要靠自动注入,主动搜索很少
Claude Code 通过 Nowledge Mem 插件接入,用法和前面几种 Agent 不太一样。每个会话开头,插件会自动注入一段记忆上下文,包括身份、规则和 Working Memory,约 750 token,中位数占首轮输入的 2.5%;我每次提交消息,它还会附上一段提醒,让 Agent 主动搜索记忆。
接入后的 162 个主会话里,154 个在开头注入了记忆,搜索提醒一共附上了 1,619 次。但真正主动搜索过记忆的只有 11 个主会话,加上 1 个子 Agent,一共 25 次召回命令、20 个召回窗口。其中确认采用的只有 2 个,都在同一次建 issue 的会话里:按记忆里的规则写英文标题和中英双语正文,再按记忆给出的项目 ID 把 issue 加进看板、设置状态。
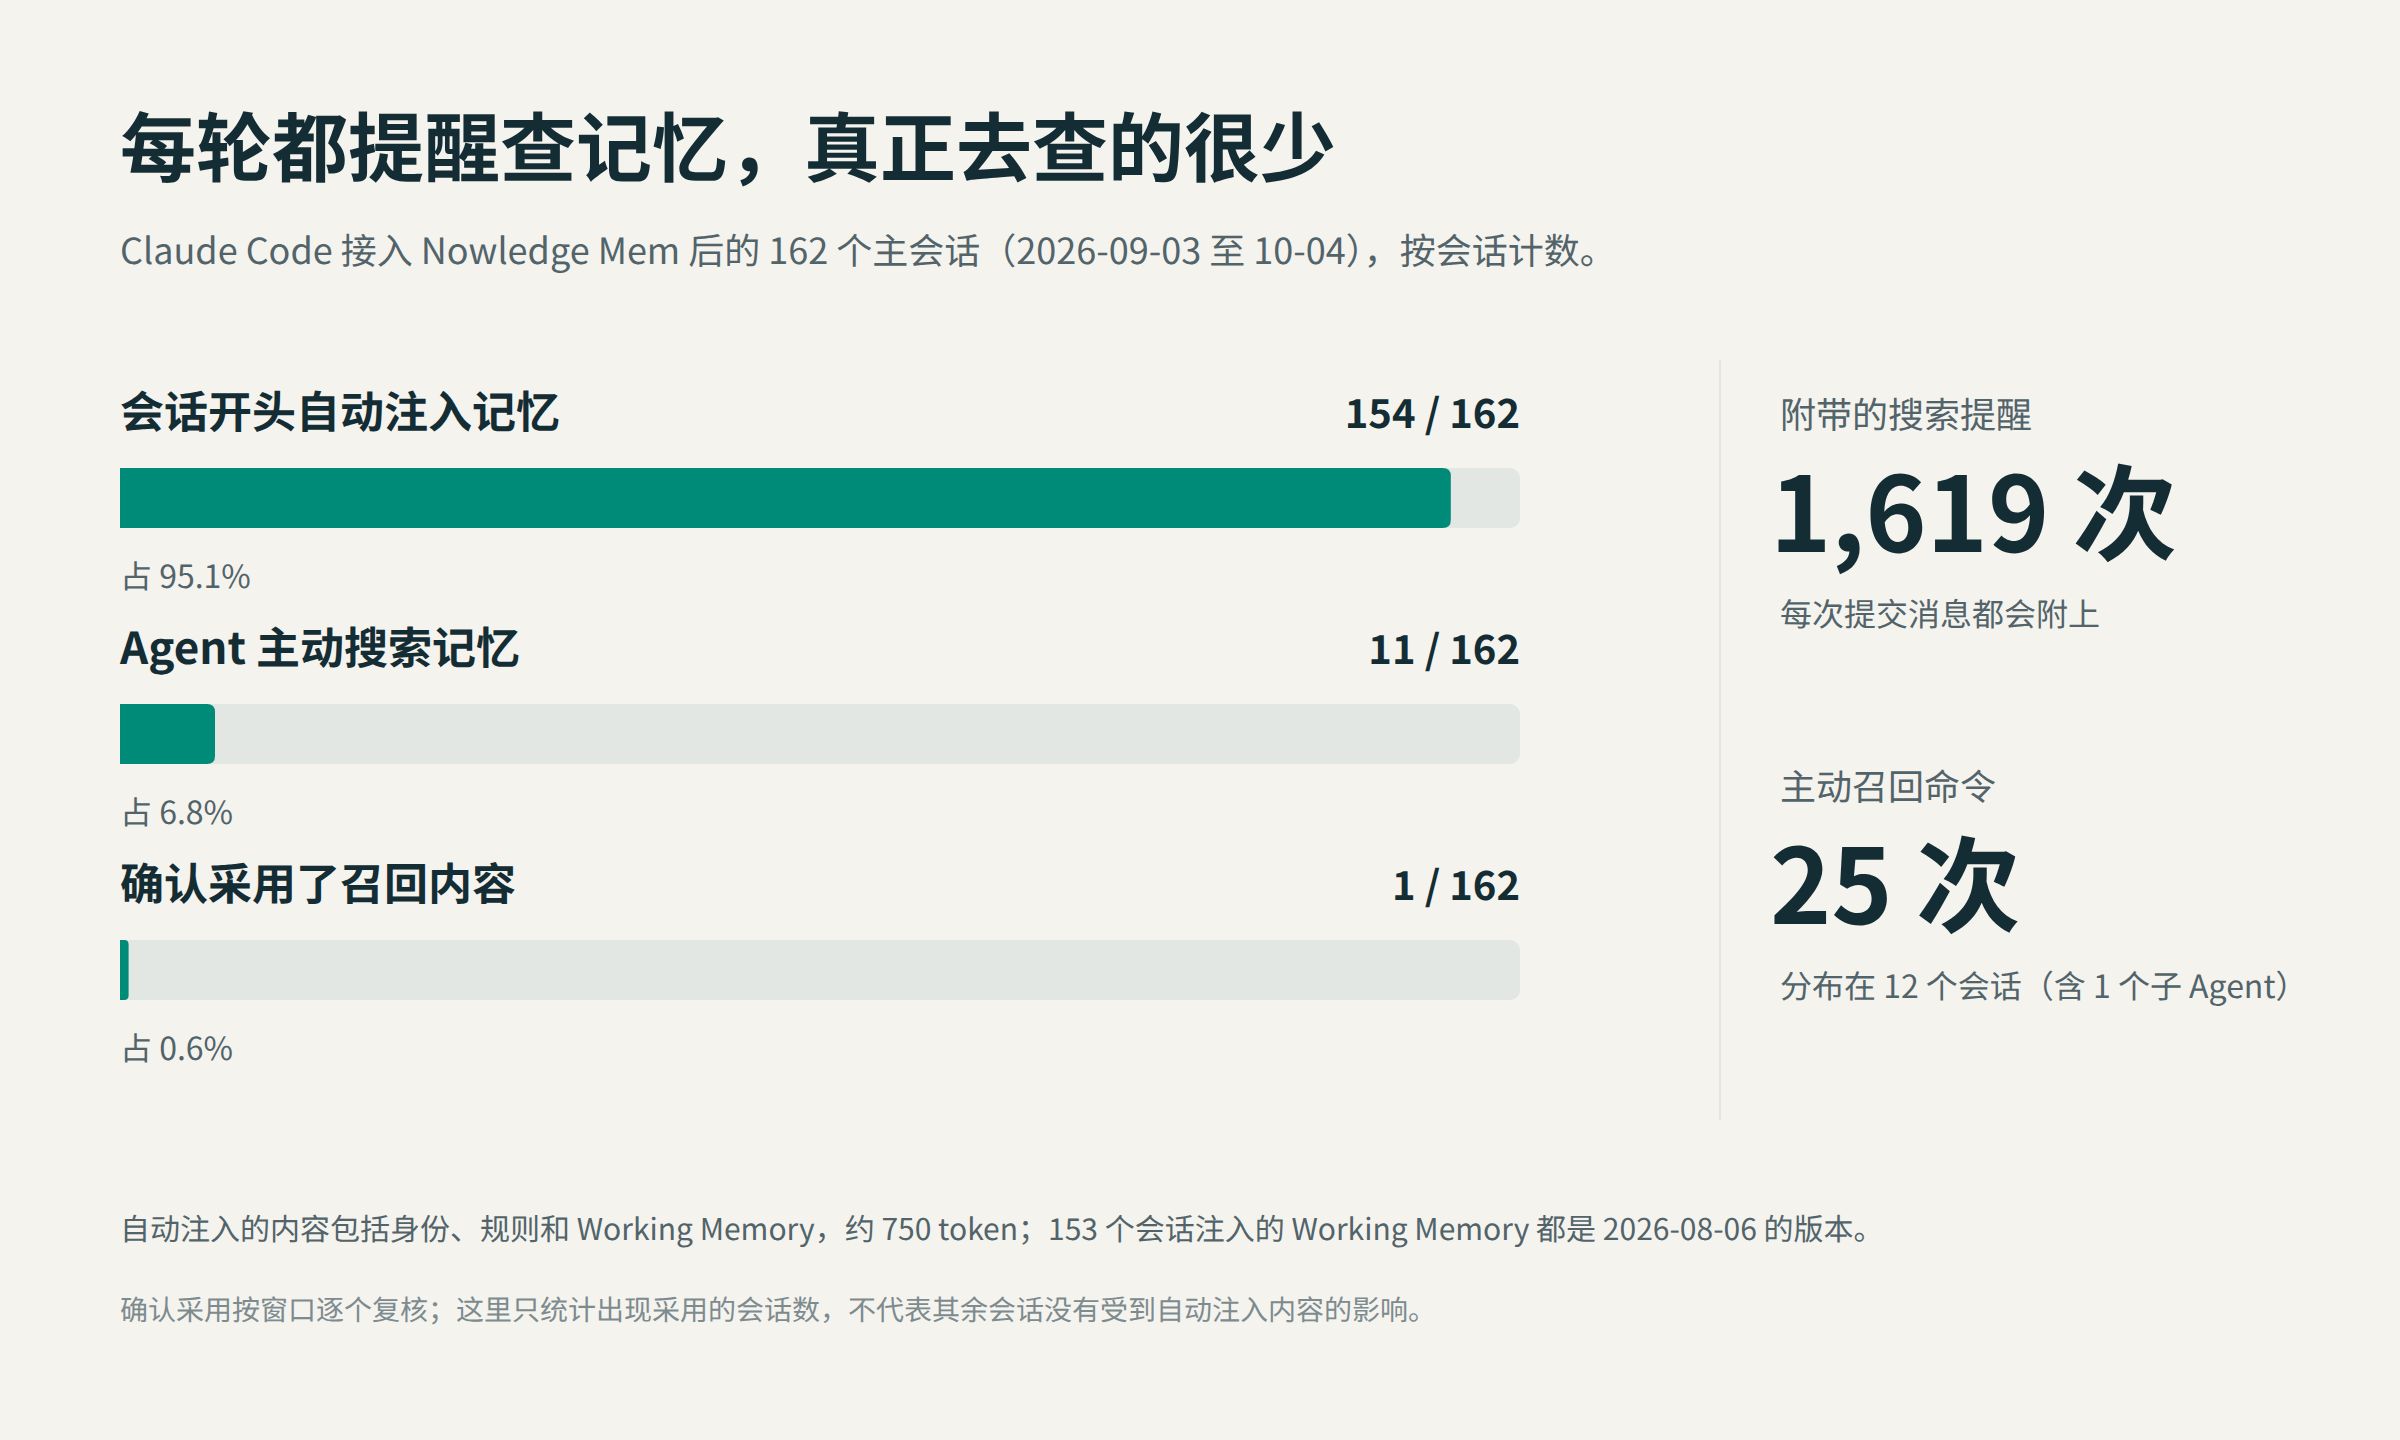
自动注入的内容也会过时。这些会话发生在 9 月 3 日到 10 月 4 日之间,注入的 Working Memory 却都是 2026-08-06 的版本。Codex 和 Hermes 的日志里也是同一版,一直注入到 10 月 28 日,共 276 次,之后才开始更新。
自动注入不需要 Agent 判断什么时候该查,但它在具体回复里起了多少作用,这次的召回窗口看不出来,还需要单独评估。
召回结果里,仍然有过时或冲突的信息
全量复核中,52 个窗口出现了过时或冲突的迹象。有些旧信息和当前要求不一致,有些历史描述已经不能完整反映当时的状态。召回之后,仍然需要核实和取舍。这个比例不是很严重,模型应该也能直接 resolve。
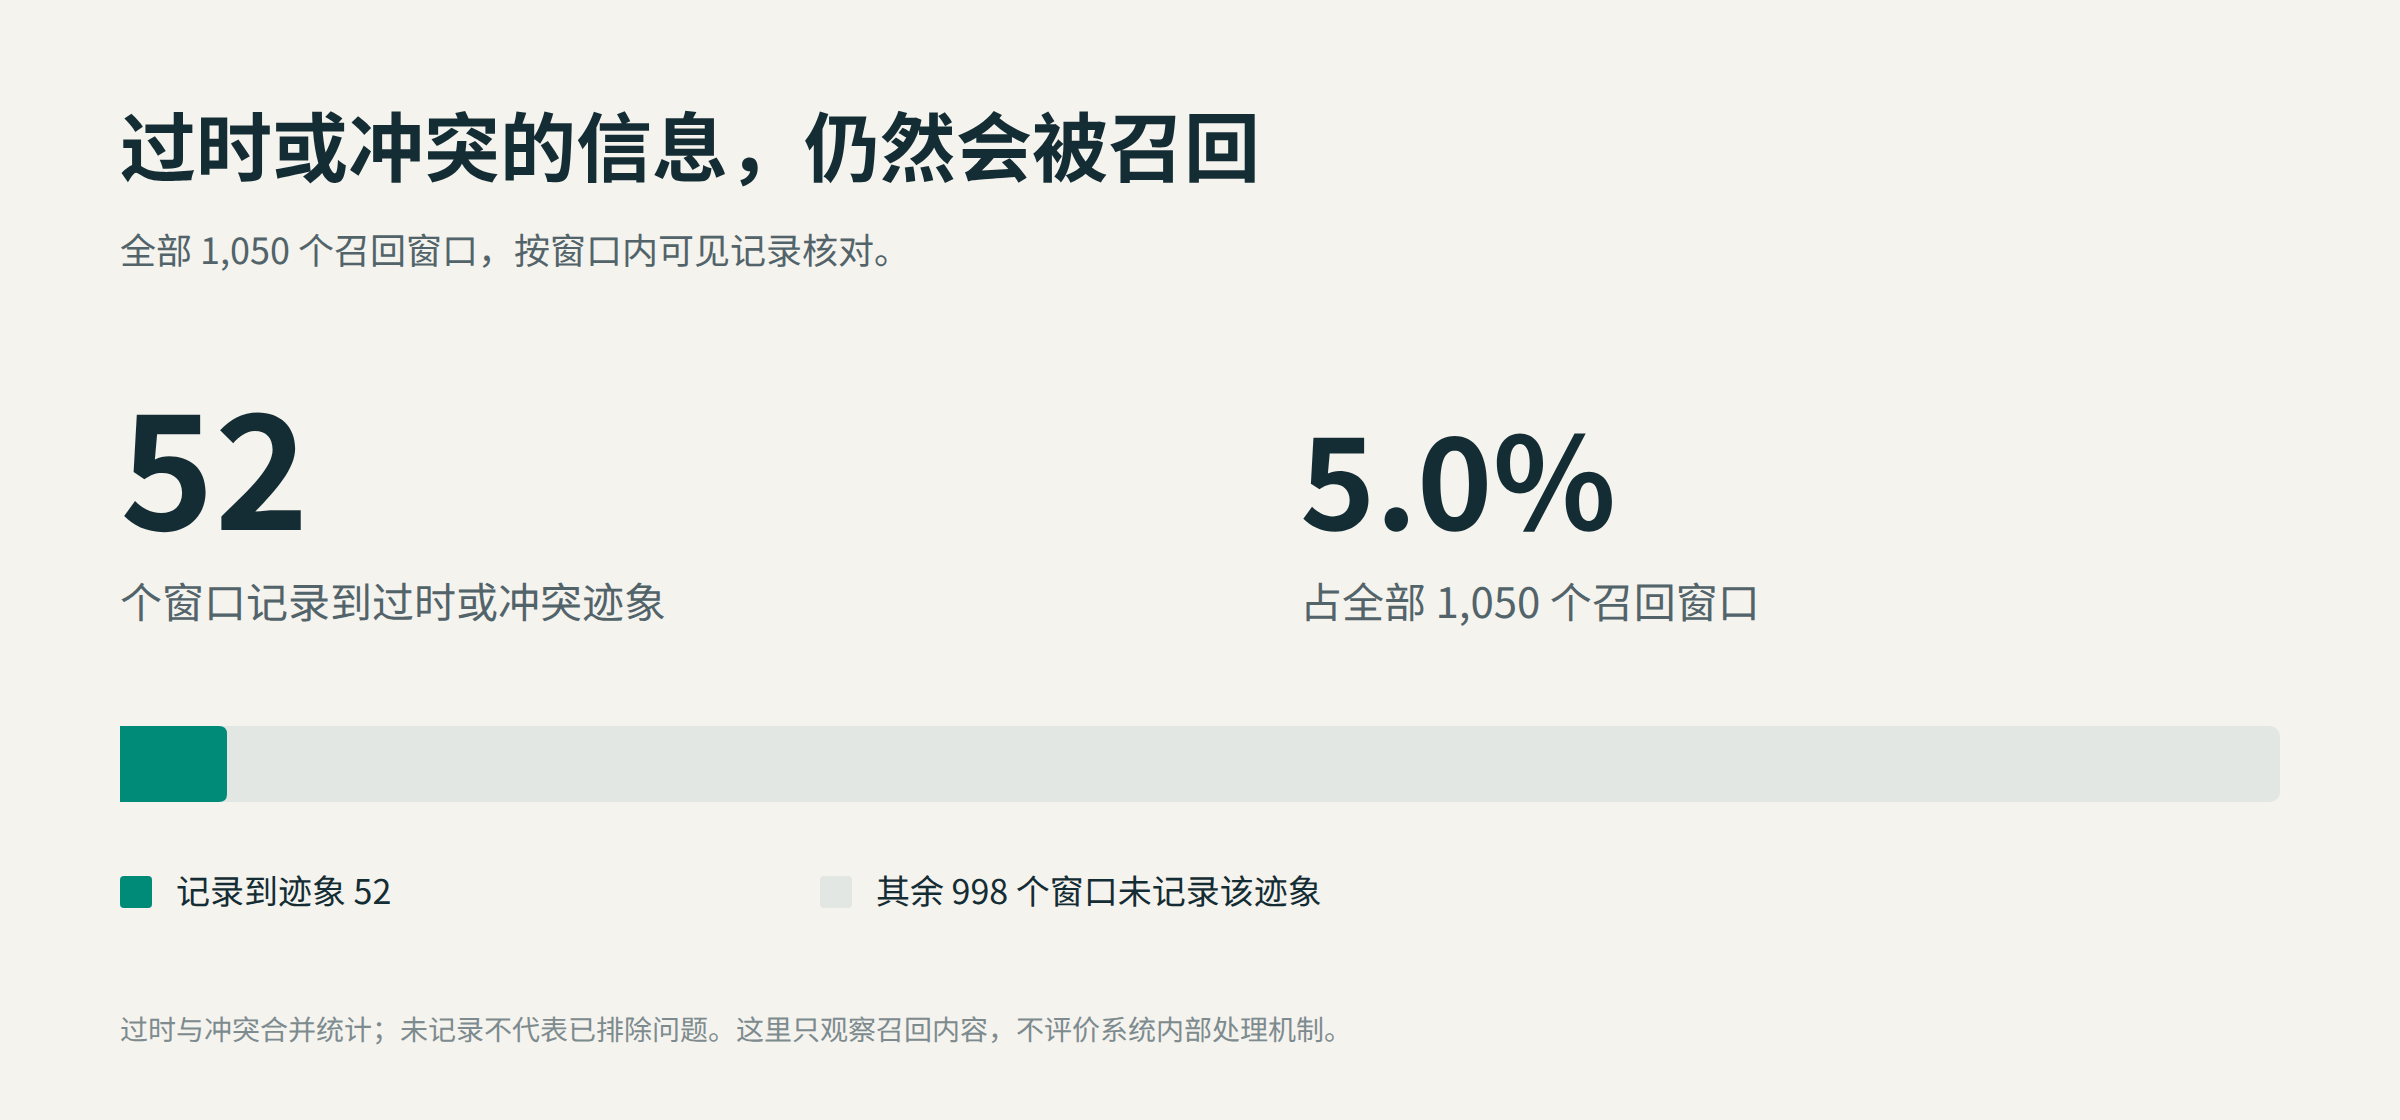
其中,5 个确认采用窗口伴随着过时、冲突或用户纠正。旧信息有时也会被采用。这里统计的是出现迹象的窗口数,过时与冲突合并计算。
好,核心发现看完了,接下来用几个案例看看记忆具体起了什么作用。使用环境与数据口径放在文末附录。
记忆在具体任务里起了什么作用?
前面的数字回答了“多少次召回能确认被用上”,却还没有说清楚:用上的那一刻,记忆具体做了什么。
我从复核记录里挑了几组案例,沿着当时的任务往下看:Agent 原本知道什么,记忆补回了什么,它后来又做了什么。这些案例是为了看清不同的作用,各类案例的数量不代表它们在全部记录中的比例。
按已有约定创建 GitHub 的 issue
这也是我最常用的一个场景,我让 Agent 在 GitHub 上创建一条 issue,用来记录接下来要处理的工作。由于我们之前约定过标题和正文的格式、应该放进哪个项目看板,以及创建后要检查什么。那次我没有重新交代这些细节,只让它先看一下记忆里的创建方法。
召回带回了这些约定,还指向一份更详细的操作说明。Agent 随后读了说明,检查是否已有重复的 issue,按要求创建新条目,再核对它有没有进入正确的看板——也就是用来跟踪事项进度的地方。一次查询没找到刚创建的条目,它又用条目的编号继续核对,最后确认了归属。
这次让我觉得有价值的,是过去已经说清楚的规则,真的接上了眼前的操作。我没有重讲整套流程,它也按约定执行了。
不过,针对于这种 case,我必须得跟 Agent 说得非常明白,指定让他去我的记忆库里找到相关的记录,才能进行下一步操作。所以,当我不提进系统的事情,直接让他去创建 issue 的话可能就没这么顺利:Agent 会先把 issue 创建成了错误的格式,我指出后,它才查回规范、读取说明,开始纠正。
检查服务器的自动清理配置是否生效
另一个例子来自服务器维护。
我们服务都是通过打包成镜像的形式,push 到 registry 里面的,线上的服务器更新服务就是拉最新的镜像,因此旧版本如果一直留着,就会占用磁盘。我们之前调整过自动清理规则,后来我想确认:那次改动到底有没有生效?
记忆里保留了改动的经过:原来的定时清理任务已经停用,改由系统自带的机制处理,新的设置也已经写进配置文件。不过,当时还没有确认运行中的服务是否用上了这些设置。
Agent 顺着这条线索,检查运行状态、配置文件和修改历史。结果发现,文件虽然改了,正在运行的服务却仍然按旧设置工作。记忆把核查目标带了回来,现场检查才给出了“尚未生效”的证据。
这也是我比较认可的一种用法:不用从头猜当时做过什么,可以沿着留下的线索继续查。
但后面的建议仍然需要核实。Agent 起初建议重启服务;我继续追问后,它又查了相关实现,改为暂时保留配置,不立即重启,同时修正了旧记录里的一处版本信息。也就是说,这次确实用到了记忆,过程里却仍然有需要追问和纠正的地方。
做完两轮就停下,是记忆起了作用吗?
有一次,我们尝试让 Agent 自己去优化某一个 pipeline。
为了避免一直在这一处微调,我们提前约定了上限:只做两轮,之后先停下来,把精力放回后续任务。
模型把这个限制写入了记忆。在它迭代几轮后,它又把这个刚刚写入的记忆做了召回,自然而然的,它在后续也沿用了这个停止条件,把这轮优化收住了。
如果只从召回之后开始看,很容易觉得是记忆让它及时停了下来。但把前面的对话也放回来看,我此前就已经要求设置上限,它在查记忆之前也已经答应过,两轮之后不再继续。
所以,这次能确认的是它保持了前后一致。至于最后停下来,有多少是这次召回带来的额外帮助,日志里分不出来。记忆可能起了复核和提醒的作用,却不能把原本已经做出的决定,全部算成它的功劳。
用旧记录判断 Orca 的现有能力
还有一次,我想确认 Orca 能不能把 Agent 任务交给另一台机器运行。Orca 是我工具链里的一个开源工具,用来组织和执行 Agent 任务。
Agent 找到了一条早期实现记录,里面提到本地数据库(SQLite)、终端里的任务执行进程(worker),以及当时的任务调度方式。它读完后,判断 Orca 缺少跨机器执行的能力。
我随后追问 Orca 是否已经有 Web 服务端。Agent 这才查看当时版本的命令行帮助,发现其中已经有服务端、远程环境和远端 worker 的相关能力,能让另一台机器上的执行进程承担任务,于是更正了上一条回答。
这次,旧记录确实进入了回答,却没有带来正确的判断。它没有完整反映当前版本,Agent 也可能把一段过去的实现描述,理解成了现在全部的能力。
不能只凭这个例子说是记忆导致了误判,但如何告诉模型这可能是一个旧的信息呢?(或者这个场景下记忆是否正的要起作用呢)
找回一套分类规则的来龙去脉
最后一个例子,作用没有前面那么显眼。一个项目里有一套给信息分类、打标签的规则。后来我想知道,眼前这些分类为什么这样划分,是一路怎么调整过来的。
Agent 已经能列出当前有哪些分类,但还在核对它们的来源。这次记忆找回了早先的讨论:哪些类别拆分过,遇到现有分类放不下的条目时怎么处理,以及分类和名称曾经怎样调整。
它把这些经过补进了解释,又继续核对配置文件。这样,眼前的规则就有了一些历史线索,可以继续查证,不必只看当前结果来猜。
这个窗口里,看不到它由此改变了某个实施方案;这几条旧记录,也不足以证明整套分类的来源都已经解释清楚。能确认的帮助,是它补回了一段过去的经过,让后续核查有了方向。
同样是“采用”,有的是找回规则,有的是提供线索,有的是保持一致,也可能把过时的判断带回来。读完具体经过,再回头看采用率,我觉得需要继续分清这些差别。
“记忆被用了”,离“记忆好用”还有几步?
看完这些案例,我越来越觉得至少需要区分四层:
- 它返回了与任务相关的内容。
- 这些内容出现在后续回复或行动里。
- 它补充了当前上下文里缺少的信息。
- 这条信息让判断、行动或最终结果变得更好。
全量复核时,评审也逐一检查:被用上的信息,召回前是不是已经出现过?它推动了下一步,还是只是复述、保持一致?前面的统计已经区分了这些作用,但“补充新信息”和“推动下一步”仍然只是窗口内看得见的证据,不是任务结果。
“下一次召回之前”只是一个便于观察的边界。下一次查询有时恰恰是上一条线索引导出来的继续调查,并不意味着上次召回没用。
同样,回复里没写出来的信息,可能参与了选项排除;一个影响很大的约定,也可能只需要在几十次调用里被找回一次。我们还没有衡量这些价值,不能用窗口采用率把它们一笔抹掉。
因此,12.4% 不能解释成“记忆只有 12.4% 的时候有用”;57 次“补充新信息并推动下一步”,也不能解释成“57 次决策得到了改善”。
Nowledge Mem 内部观察
我对 Nowledge Mem 这个工具本身的设计也比较感兴趣,所以也做了一些统计,看看它内部几种检索和读取方式在实际使用中有什么差别。
Nowledge Mem 提供的不只是“搜记忆”。日志里能看到四种主要用法:搜索记忆条目(Search Memory)、搜索历史会话(Search Thread)、按 ID 读取某条记忆(Retrieve Memory),以及读取某段会话的原始消息(Fetch Thread)。
先在全量日志里分开看:
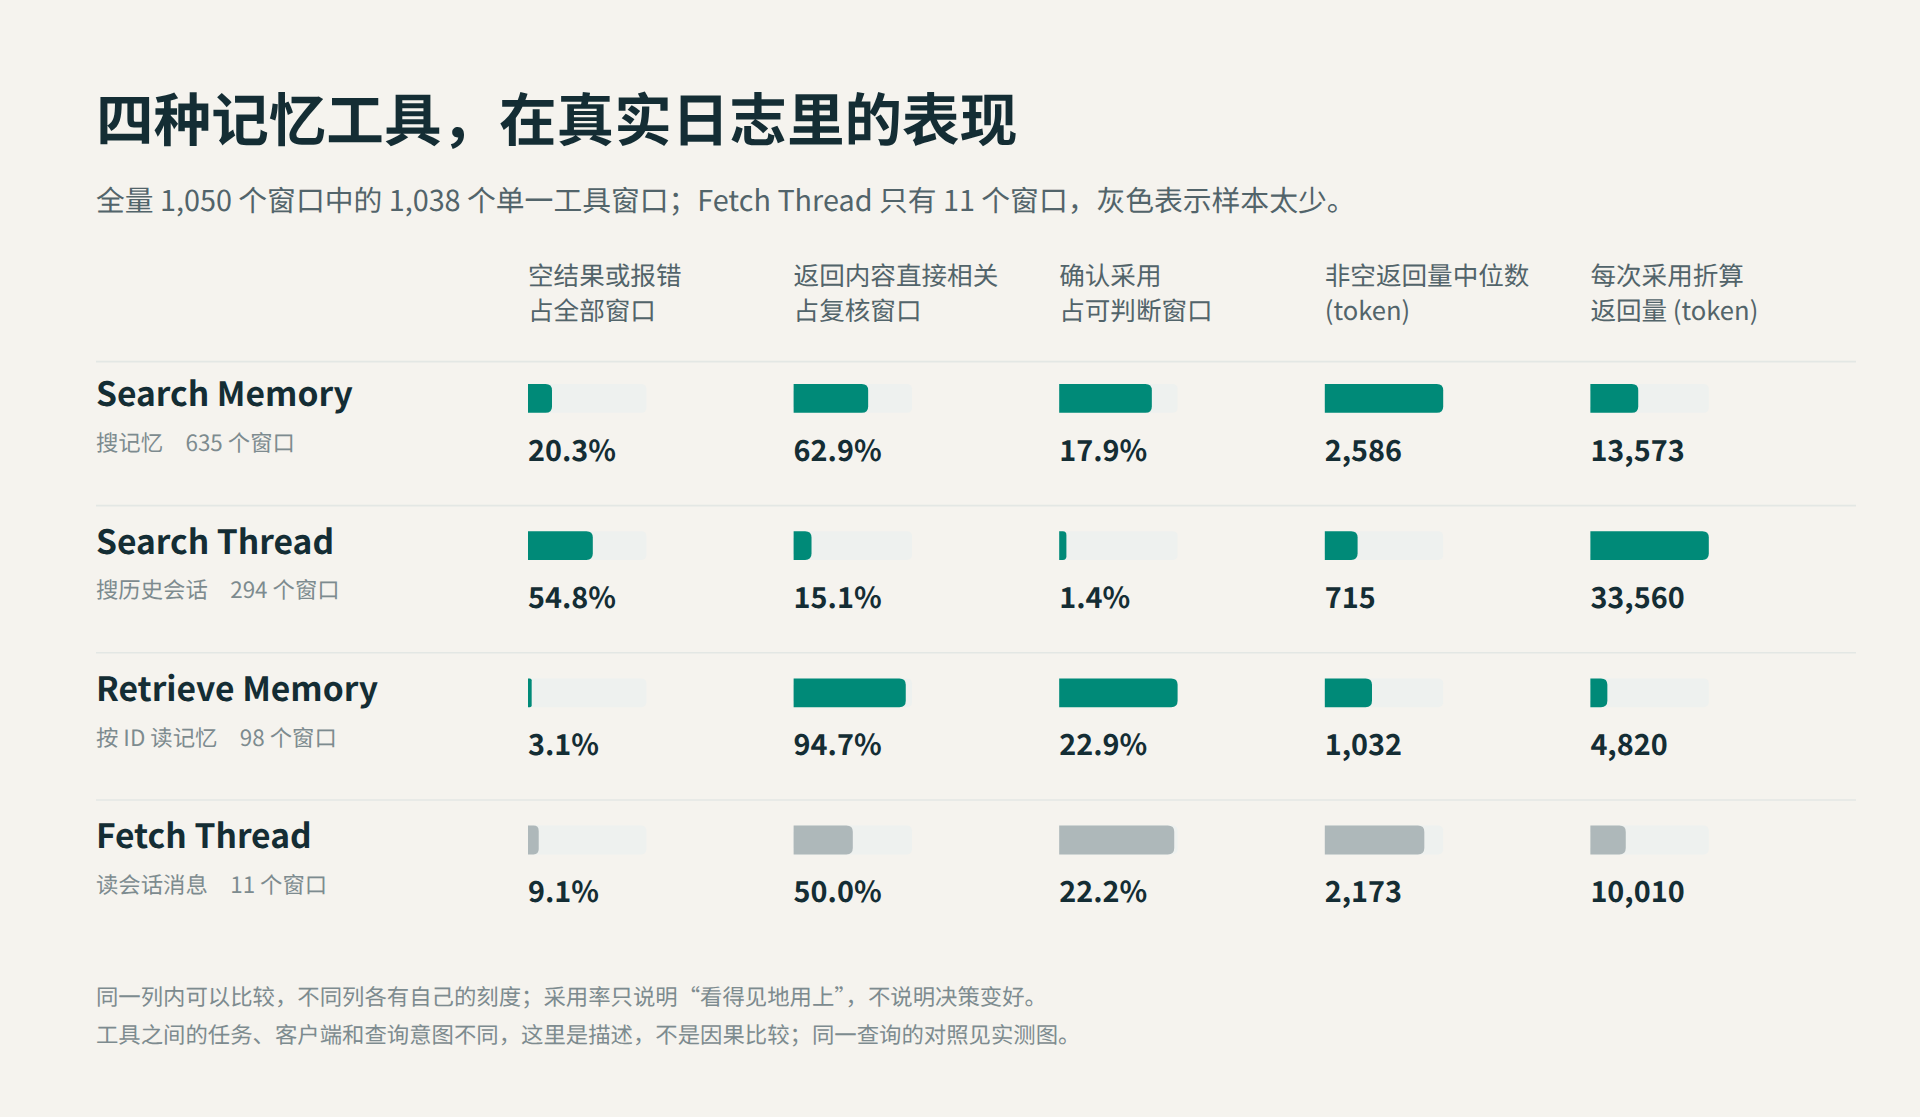
- 搜记忆:635 个窗口,20.3% 为空或报错;有可见回复的窗口里,62.9% 的返回与任务直接相关;采用率 17.9%(85 / 475)。有结果时,单次返回中位数约 2,586 token。
- 搜历史会话:294 个窗口,54.8% 为空或报错;返回与任务直接相关的只有 15.1%;采用率 1.4%(4 / 285)。有结果时,单次返回中位数约 715 token。
- 按 ID 读记忆:98 个窗口,采用率 22.9%(8 / 35),但其中不少是在更新记忆前读旧版本,属于维护。
- 读会话消息:只有 11 个窗口,样本太少,不做比较。
在 43 个两种搜索都用过的会话里,搜记忆的采用是 26 / 148,搜会话是 0 / 204。
日志里的耗时也差得很多。以 Codex 为例,搜记忆的中位耗时约 1.3 秒(235 次),搜会话约 0.2 秒(172 次),按 ID 读记忆约 0.1 秒。
但历史日志里,两种工具面对的问题并不一样:Agent 常常是搜记忆没找到,才去翻历史会话。为了把“工具本身”和“问题难度”分开,我从日志里抽了 120 条真实查询:一半原本发给搜记忆,一半原本发给搜会话。然后让每条查询把几种路径都跑一遍,再请不知道工具名称的评审,站在当时任务的角度,判断返回结果能不能直接用。
实测使用的是现在的记忆库,因此需要尽量排除后来新增或修改的内容,接近查询当时可获得的信息。具体处理与限制放在本节末尾说明。按这个口径,结果如下:
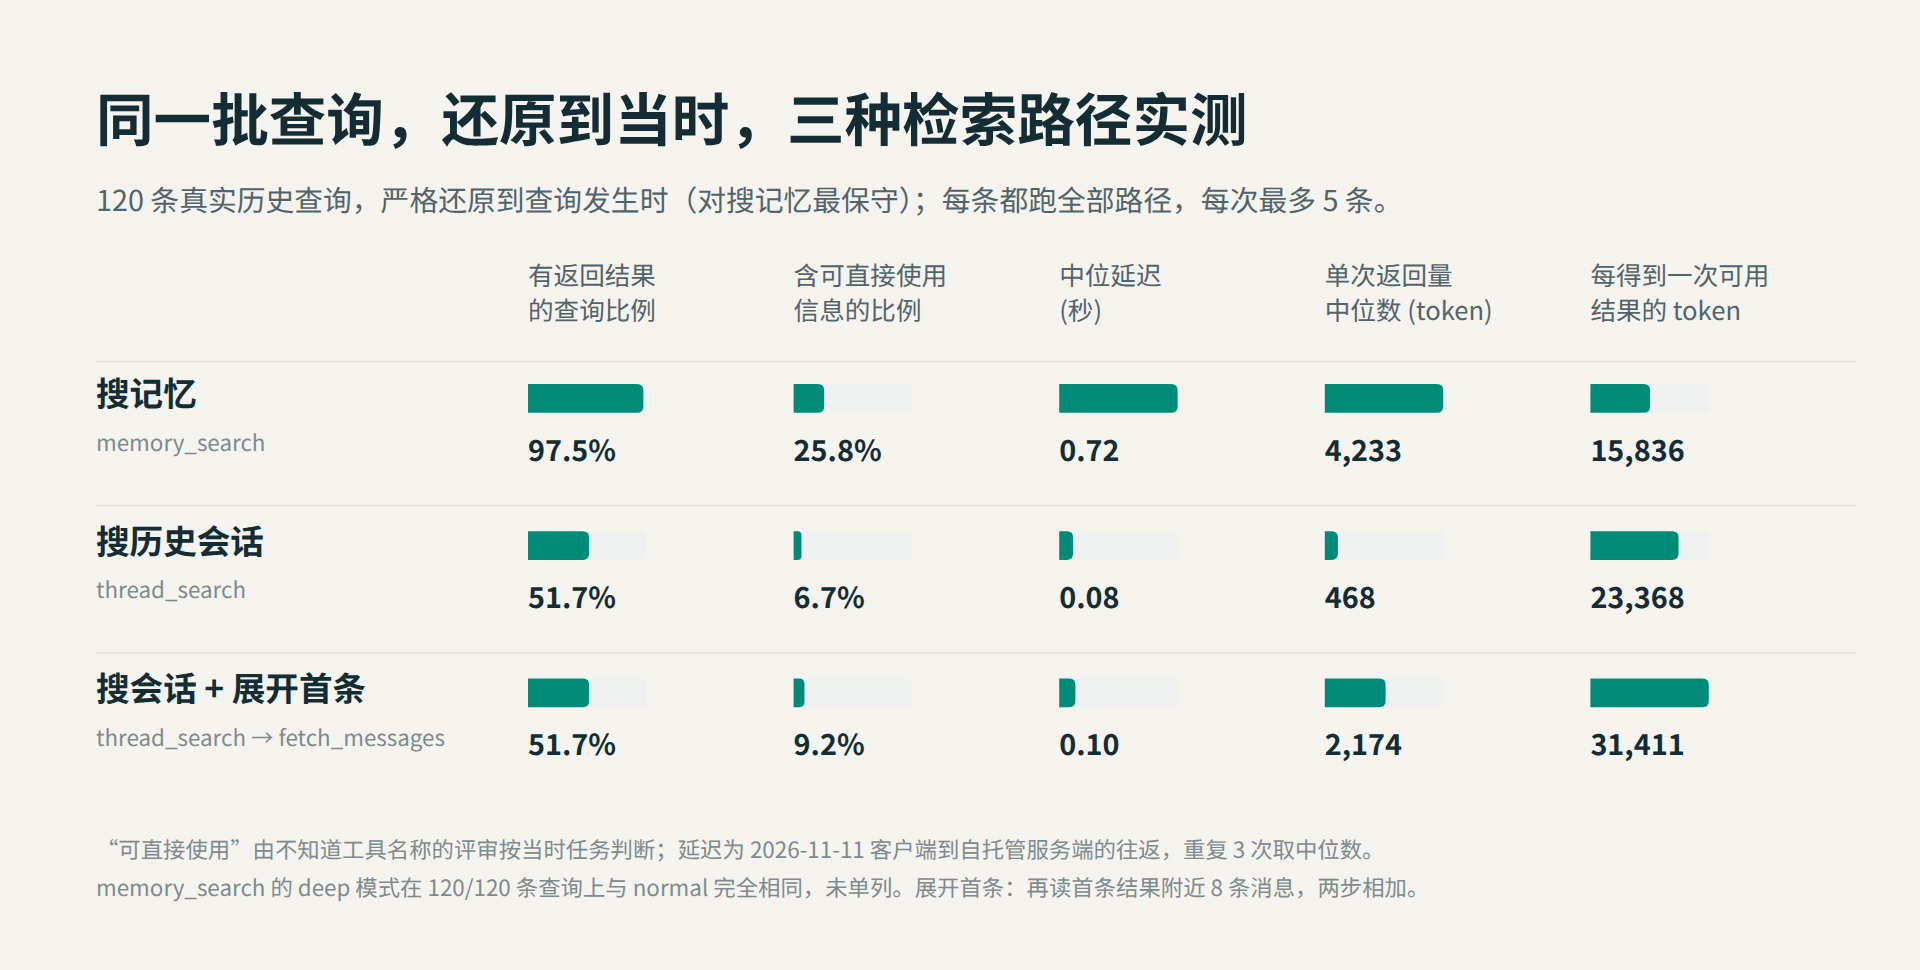
- 搜记忆:117 / 120 条查询有结果;严格还原后,25.8% 的查询含可直接使用的信息。中位延迟约 0.72 秒,单次返回中位数约 4,233 token。
- 搜历史会话:只有 62 / 120 条查询有结果,含可直接使用信息的只有 6.7%。它快得多,中位延迟约 0.08 秒,单次返回也小,中位数约 468 token。
- 搜会话后再展开首条:可直接使用的比例是 9.2%,返回量也增加到中位数约 2,174 token。
- 同一条查询上,只有搜记忆能直接用的有 29 条,只有搜会话能直接用的有 6 条。原本发给搜会话的那 60 条查询,换成搜记忆,也有 28.3% 可直接使用;搜会话自己是 5.0%。
- memory_search 的 deep 模式,在 120 / 120 条查询上返回和 normal 完全相同的结果。
在这批查询上,**优先搜记忆。**搜会话单次更快、返回更少,但 120 条查询里只有 62 条有结果。按每获得一次可直接使用的结果折算,搜记忆返回约 15,836 token,搜会话约 23,368 token,再展开首条约 31,411 token。另有 6 条查询只有搜会话能直接回答,可以在搜记忆落空后再试。
这组实测的限制
这组实测拿历史查询重新搜索,但面对的是现在的记忆库。今天搜记忆返回的前 5 条里,52% 写于原查询之后,有些就是那个任务后来产生的结论。如果把这些答案计入,就会高估当时能找到的信息。这是重跑历史查询时的评估限制。
为此,我先按创建时间保留查询之前的记忆和消息,排除发起查询的会话;再根据日志里的更新记录,剔除查询之后改过的记忆,以及发起查询的会话自己写入或改过的记忆。前面的工具对比统一采用这个更严格的口径。
不过,我们没有查询当时的完整记忆库快照,后来被改写、合并或删除的内容无法完整复原,日志之外的修改也未必能识别。因此,这仍然只是近似还原。这项限制针对重新搜索的实验;前面的可观察采用统计依据当时保存的返回内容和后续行为。
此外,“能直接用”是评审站在当时任务角度的判断,不是任务结果;评审本身也有波动,同样的内容交给两轮评审,三级判断的一致率约 94%,几个百分点的差别不必当真;每条查询只看前 5 条结果。
总结
评估要放回连续的任务里
整理完这些数据,再读 Anthropic 的 The components of agent memory,我更在意的是:我们到底该怎样判断,记忆有没有让 Agent 的工作变好?约一成的召回能确认被用上,我并不觉得低;但这次还缺少漏召回的假阴性统计,也没有不使用记忆的任务对照,仅凭采用率,还说不清整体收益。
所以,对 Agent Memory 的评估,我觉得有必要在检索信息、回答问题之外,加上一套持续变化的真实工作环境。这里既要有目标和偏好会延续的人,也要有相互关联的任务:需求会变,资料会更新,昨天的决定今天可能被推翻。我们要看的是,Agent 能不能借助记忆跟上这些变化、接续工作,并把过去的经验用到下一件事上。
LongMemEval、LoCoMo 从一开始就包含推理或总结等任务,并不只是检索。Anthropic 文中的 CL-Bench 数据库实验,以及 EverMind 的 EvoAgentBench,则进一步检查过去的经验能否帮助后续任务。这些受控实验给了我一些启发,但我更想把评估推进到上面说的真实工作环境里。
我们自己也许可以先挑几段有连续性、能重建当时背景的真实任务,比较有无记忆时的结果和成本。至于“该查却没查、该找回却没找回”的假阴性,还得回头核对任务、当时可用的记忆和已有上下文,才能确认究竟遗漏了什么。这会比复核已经发生的召回更费力,先从少量关键案例开始,可能更现实。
记忆是个框,啥都能往里装
我现在的 Agent 工作负载还是以 coding 为主,前面也展示过具体构成。但在目前这套用法里,Nowledge Mem 能看到的 Context,还是主要是来自我和 Agent 的对话。实际工作里的 Context 显然不止这些:一个 issue 怎么改了,某份资料更新了什么,一条约定后来为什么被推翻,很多事情并不发生在 AI 的聊天窗口里,更发生在 Human 层面的 Context 的流动。
那有没有可能,往里面再装进更多东西?比如把 Nowledge Mem 接到 GitHub、Slack 这样的协作和通讯工具,让它能把事项、讨论、修改和决定关联起来。对我来说,这比只留下聊天里的那一句结论,更接近一个完整的工作背景。或许记忆就更能体现其价值。另外就是如此一来 Context 会更多更杂,如何让记忆系统高效的 Dreaming,又成了一个值得研究的话题。
另外,上文也提到过,我们发现召回轮数越越靠前,实际上记忆的使用率越高(前一两次召回更加有用),如果有些信息在任务刚开始时就很有用,能不能再往前推一步?记忆系统直接让 Agent 先根据近期记录和工作环境里的变化,提出一个值得展开的问题,成为一次新 session 的起点,也就是 Agent 的主动性,就顺利成章了起来。
但如果真的盛了这么多 Context,那这还能加 AI 的记忆么?我之前在盛大的工作也是再做 Assistant 的 Memory,我也问过自己倒是什么是 AI 的记忆,不过我觉的也不必想的这么清楚,既然没想清楚,那就多多往里面装点东西吧,也就是“记忆是个框,啥都能往里装”,数据总能驱动下游的。
聊聊你的用法,也打个广告
大家平时怎么用记忆?更常留下偏好、操作规范、项目决定,还是具体的历史经过?有没有哪次记忆少让你解释了一遍、避免了一个错误,或者改变了下一步?也想听听那些“该想起来却没想起来”,以及被旧信息带偏的经历。
最后也给正在用的工具打个广告:如果还没有试过这类系统,可以看看 Nowledge Mem。这篇文章的记录,就是我实际使用它积累下来的。多个 Agent 之间能共用一套长期背景,是我愿意继续用、也愿意推荐它的原因。
如果愿意,欢迎讲一个具体例子。我很想知道,大家是怎么确认:它真的在帮忙。
附录:环境与数据
我平时在一台本地 Mac 和两台 Linux 开发机上工作,在这些环境里,我会使用 Codex、Claude Code、OpenCode、Kimi Code 等 Coding Agent。另外还有一台虚拟机专门跑 Hermes,Hermes 作为我日常除了代码开发外,其他问答任务入口。
然后我的 Nowledge Mem 是独立部署的,通过 NetBird Overlay 网络连接记忆服务。这样,无论在哪台机器、哪个 Agent 里工作,都可以实时读写记忆,找回之前的项目背景、操作约定和历史经过。
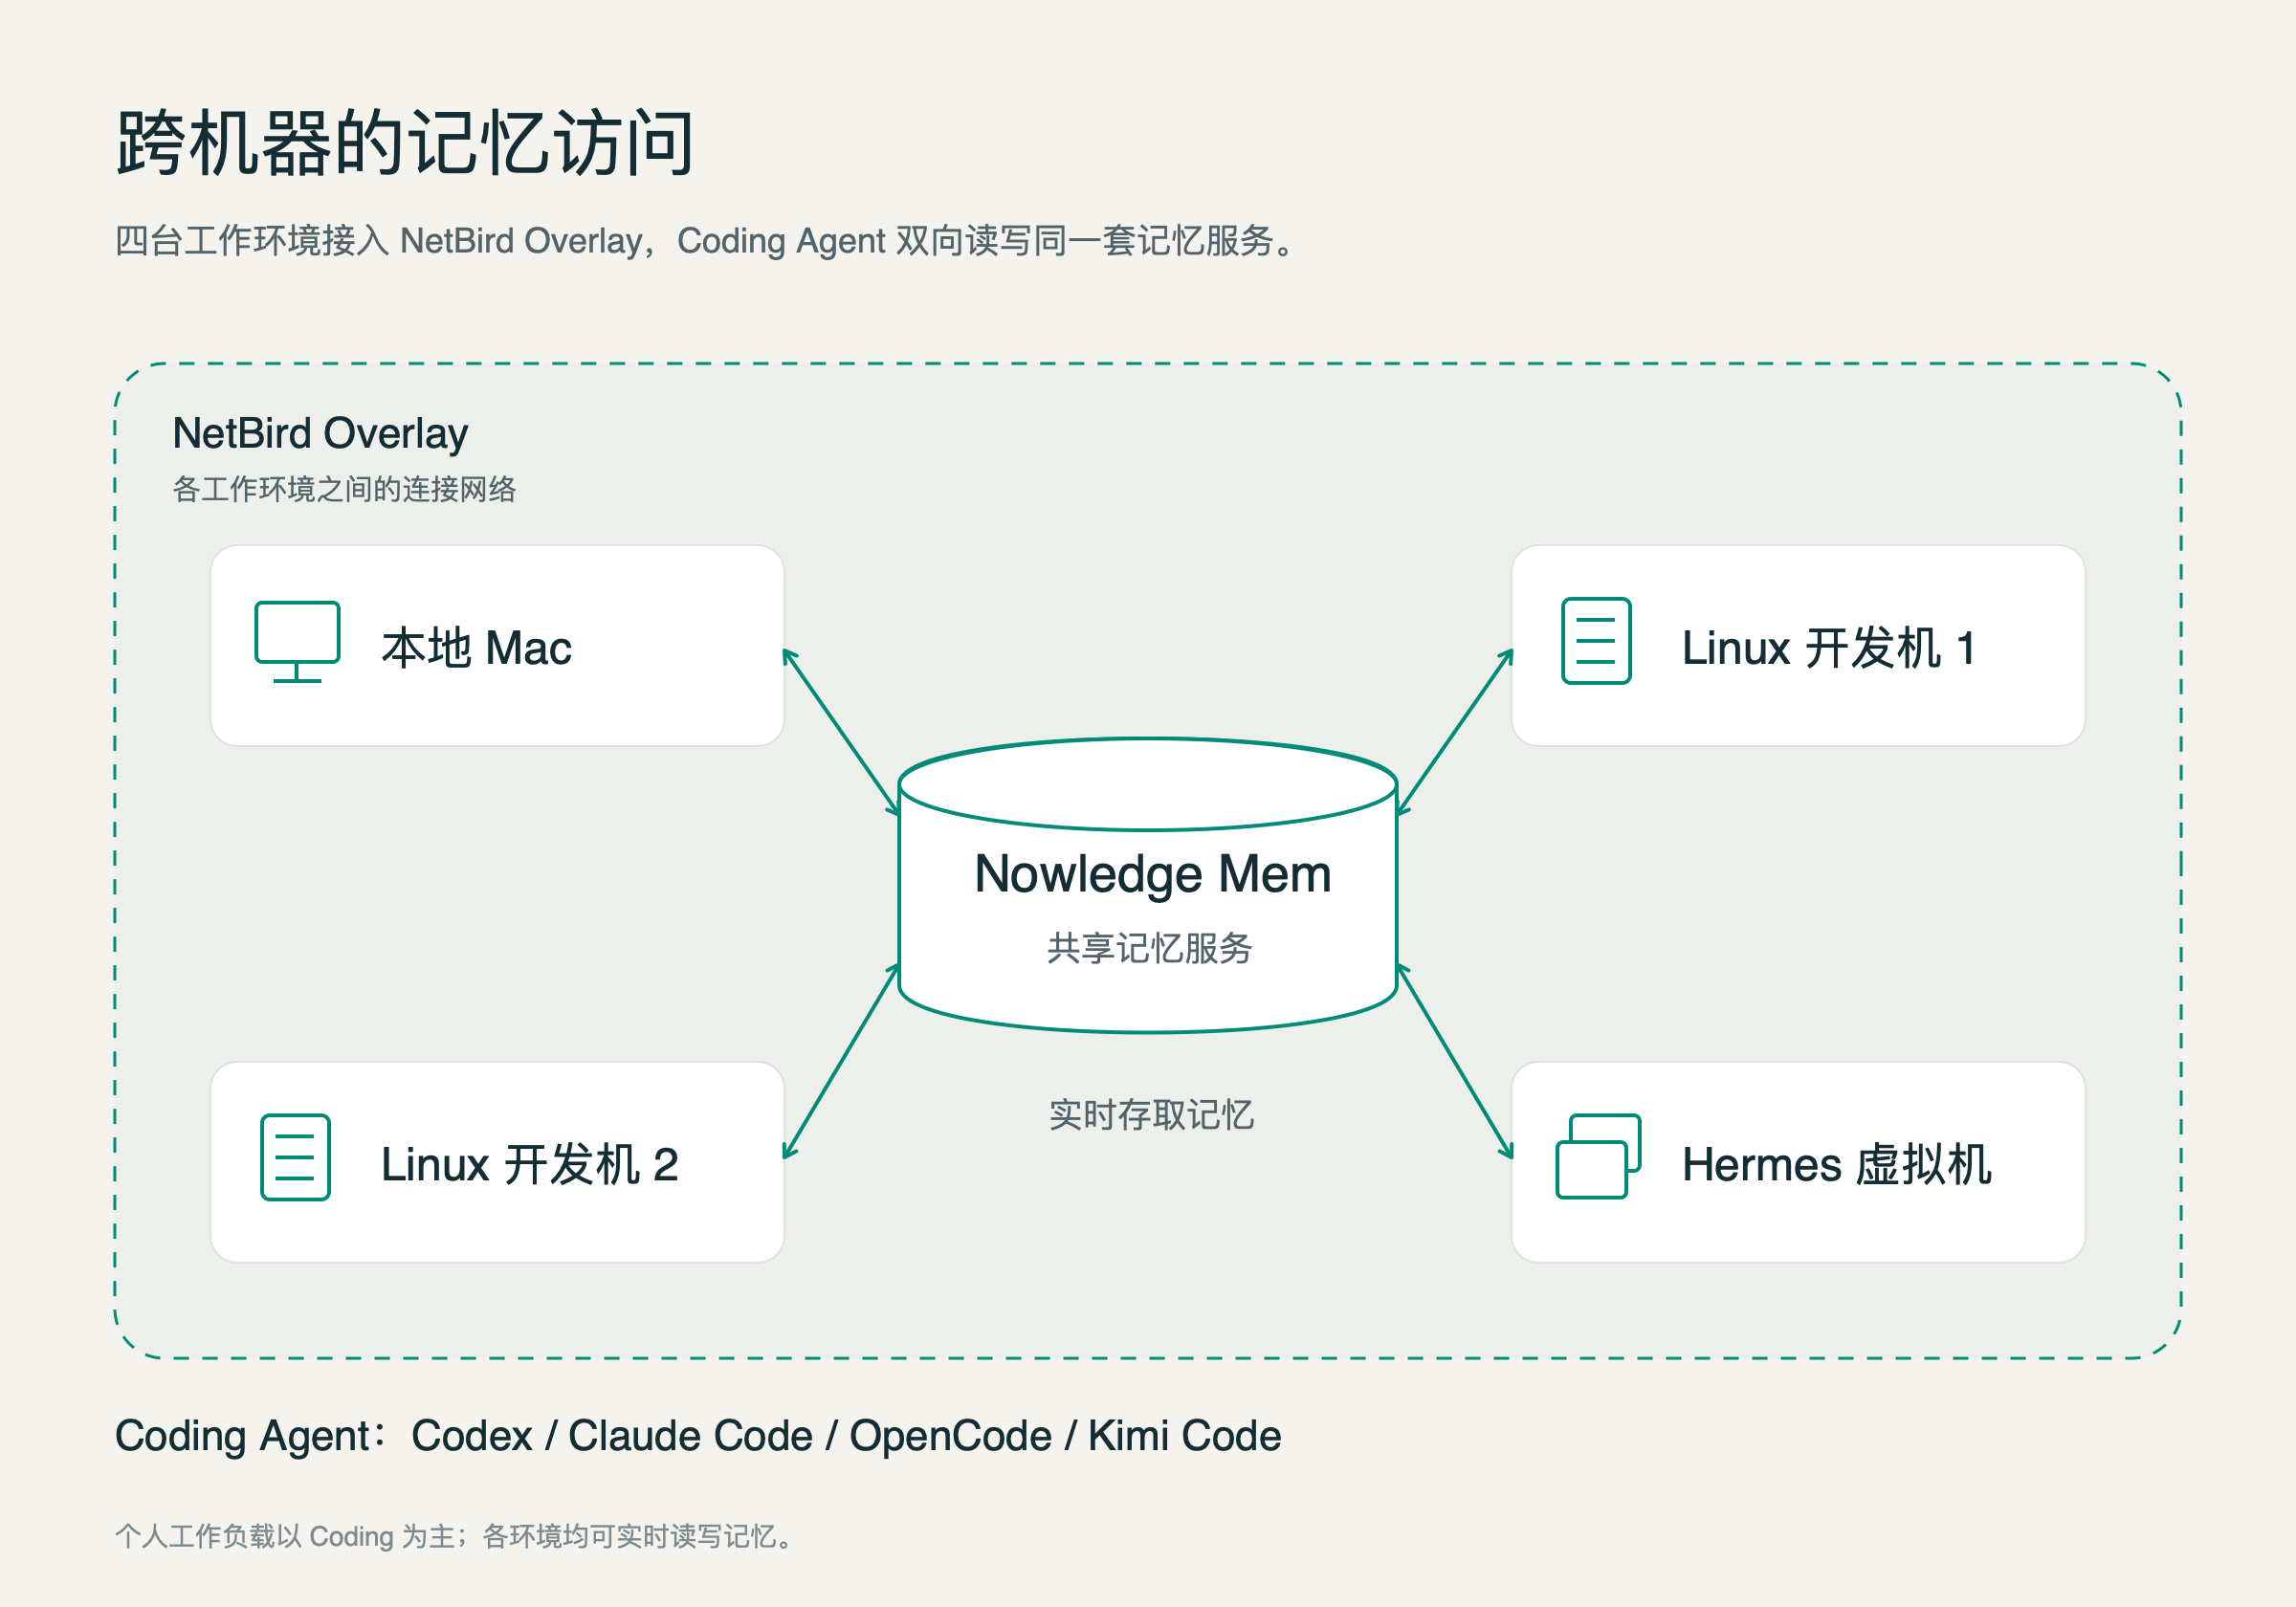
我的主要工作负载是 Coding,包括写代码、调试、核查配置和延续项目工作。按会话细分,写代码约占四成,运维、调研和写作也不少,见前面的工作场景。文中的结论与发现来自我个人在这些环境里的使用记录,反映的是这类工作中的表现,不能直接代表所有用户或所有记忆场景。
我一共整理出的这些环境中的所有 3,230 份会话记录,然后以 6 月 29 日为界:这天我开始用 Nowledge Mem 做的初步筛选,然后逐条去做排查,只有明确有我的提示,或者有相关记忆工具调用的,才会被真实地统计到,筛后总共 1,078 个会话,共 5,533 条 message。
最后就是 Claude Code 默认只保留 30 天会话(这个真的太阴间了),7、8 月接入后的会话在备份前已经被自动清理,能分析的是 9 月 3 日到 10 月 4 日之间的部分。
从日志中识别记忆调用、去掉会话分叉继承历史造成的重复后,得到 1,050 个召回窗口:一次召回之后,到下一次召回、上下文压缩或日志结束之前,算一个窗口。空结果、报错等情况按规则归类;有可见回复的窗口,由 AI 评审逐个对照召回前的上下文、返回内容、后续回复和动作。每个“确认采用”都要给出逐字证据,并用程序核对引文;48 个窗口由两名 AI 评审独立判断,四类结论的一致率为 91.7%。语义判断全部由 AI 完成,没有人工逐条复核。
最终,814 个可判断窗口包括 101 个确认采用、618 个未观察到采用和 95 个记忆维护;另有 236 个证据不足,不进入采用率的分母。记忆维护包括写入前查重、更新前读取旧版本和连接测试,没有算作采用。
工具实测另外使用了 120 条真实历史查询,一半原本发给搜记忆,一半发给搜会话。每条查询都测试几种检索路径,再由不知道工具名称的 AI 评审,按当时的任务背景判断返回能不能直接用。这项实测衡量的是返回内容,和日志里的采用率是两个指标;这批查询不含 Claude Code。
按 Agent 和工作场景比较召回频率时,每台机器上的每个 Agent 从它接入记忆的时间算起,所以只用其中的 941 个会话;提示去掉了 Agent 自动附加的提醒、环境信息和命令输出。“提到记忆之后发起”是按关键词粗略统计的。工作场景由 AI 按统一规则分成十类;随机抽 240 个单元,由另一名 AI 独立再分一遍,一致率 90%,κ = 0.88。另外 137 个会话发生在该 Agent 接入记忆之前,是后来补分类的:两名 AI 各分一遍,一致率 78%,κ = 0.71,分歧多是游戏界面的修改该算编码开发还是产品与设计,30 个分歧交给第三名 AI 裁决。
记忆的年龄和来源,按这条记忆在日志里第一次出现的时间和会话推算,不含 Claude Code。第一次出现可能是写入,也可能是第一次被搜出来,所以算出的年龄偏小,来源也不一定是写入它的 Agent。
安装、连接检查和配置调试阶段的调用没有统一剔除。这些数据覆盖不同客户端、任务和接入阶段,不能直接代表目前稳定配置下的效果,也不适合用来给不同 Agent 排名。